Tech

Microservices oder nicht? Dein Team hat sich bereits entschieden

10. Nov. 2021

Lass uns das Thema der Microservices-Architektur ein wenig tangential angehen. Die meisten Diskussionen darüber drehen sich um technologische Aspekte: Welche Sprache man wählen sollte, wie man die meisten RESTful-Services erstellt, welches Service Mesh am leistungsfähigsten ist usw.

Bei VSHN haben wir jedoch schon vor langer Zeit herausgefunden, dass der wichtigste Erfolgsfaktor für Softwareprojekte die Menschen sind. Und die These dieses Artikels ist, dass die Wahl von Microservices als Architekturmuster mehr mit der Organisationsstruktur deines Unternehmens zu tun hat als mit den technologischen Zwängen und Funktionen des Endprodukts.

Oder anders ausgedrückt: Dein Team hat sich bereits für eine Architektur für ihre Software entschieden, auch wenn es sich dessen nicht ganz bewusst ist. Und siehe da: Microservices könnten das sein oder auch nicht.

Definition

Zunächst einmal müssen wir die Microservices-Architektur definieren. Was ist das?

„Microservices“ ist ein Architekturmuster, bei dem die Funktionalität des gesamten Systems in völlig unabhängige Komponenten zerlegt wird, die über das Netzwerk miteinander kommunizieren.

Das Gegenstück zur Microservices-Architektur ist der so genannte „Monolith“, der in den letzten 25 Jahren der häufigste Ansatz für Webapplikationen und -dienste war. In einem Monolithen sind alle Funktionen der Anwendung, von der Datenverwaltung bis zur Benutzeroberfläche, in einem einzigen Binary oder Paket enthalten.

Auf der gegenüberliegenden Seite der Strasse finden wir die Microservices-Architektur, bei der jeder Dienst für seine eigene Implementierung und Datenspeicherung verantwortlich ist.

Per Definition sind Microservices feingranular und haben einen einzigen Zweck. Sie weisen eine starke Kohäsion auf, d. h. die von ihnen eingekapselten Vorgänge sind in hohem Masse miteinander verbunden. Sie sind ein Beispiel für das „Single Responsibility Principle“. Sie werden auch separat bereitgestellt, mit deutlich abgegrenzten Kontexten, und sie erfordern DevOps-Ansätze für ihre Bereitstellung und Verwaltung, wie Automatisierung und CI/CD-Pipelines.

Sehr wichtig ist, dass die Microservices-Architektur eine „Share-Nothing-Architektur“ ist, bei der die einzelnen Dienste niemals gemeinsamen Code über Bibliotheken teilen, sondern die gesamte Interaktion und Kommunikation auf das sie verbindende Netzwerk beschränkt ist.

Und nicht zuletzt sollten Microservices (wie der Name schon sagt) so klein wie möglich sein, einen geringen Speicherbedarf haben und in Sekundenschnelle starten und stoppen können.

Angesichts all dieser Merkmale sind Microservices das mit Abstand komplexeste Architekturmuster, das je geschaffen wurde. Es ist schwer zu planen, kann die Komplexität von Projekten drastisch erhöhen und war für einige Teams erfahrungsgemäss nicht zu bewältigen.

Geschichte

Die Idee, dass sich „Komponenten gegenseitig Nachrichten schicken“, ist absolut nicht neu. Bereits 1966 prägte einer der grössten Informatiker aller Zeiten, Alan Kay, den Begriff „objektorientierte Programmierung“. Die Industrie hat seine ursprüngliche Definition, die wie folgt lautete, übernommen und verformt:

OOP bedeutet für mich nur Messaging, lokale Speicherung und Schutz und Verstecken von State-Process, und extreme Late-Binding aller Dinge.

Alan Kay, Quelle.

Dieser Text stammt aus dem Jahr 2003, der folgende aus dem Jahr 1998:

Die grosse Idee ist „Messaging“ – das ist es, worum es im Kern von Smalltalk/Squeak geht (…) Der Schlüssel zum Aufbau grossartiger und wachstumsfähiger Systeme liegt eher darin, zu entwerfen, wie die Module kommunizieren, als was ihre internen Eigenschaften und Verhaltensweisen sein sollten.

Alan Kay, Quelle.

Alan Kay entwickelte in den 1970er Jahren die Programmiersprache Smalltalk, die auf diesen Konzepten basiert. Und nach der Lektüre der obigen Texte wird klar, dass die Microservices-Architektur zu einem grossen Teil eine Umsetzung von Alan Kays Ideen von Messaging, Entkopplung und Abstraktion ist, die auf die Spitze getrieben wurde.

Um den heutigen Stand der Microservices zu erreichen, waren jedoch viele weitere Durchbrüche erforderlich. In den 2000er Jahren wurde mit dem Aufkommen von XML, dem SOAP-Protokoll und den damit zusammenhängenden Webdiensten der Begriff „serviceorientierte Architektur“ zu einem weit verbreiteten Grundnahrungsmittel in Architekturdiskussionen. Mit dem Aufkommen agiler Methoden wandte sich die Branche dem REST-Ansatz anstelle von SOAP zu. Im letzten Jahrzehnt ermöglichten das Aufkommen von DevOps und der Aufstieg der Containerisierung durch Docker und Kubernetes den Teams schliesslich die Bereitstellung von Tausenden von Containern als Microservice-Architektur, dank des gesamten Katalogs der Cloud-Native-Technologien.

Pro und Kontra

Wenn Microservice-Architekturen so komplex sind, warum sollten sie dann eingesetzt werden? Es stellt sich heraus, dass sie viele Vorteile bringen können:

  • Da jede Komponente vollständig von den anderen isoliert werden kann, können die Teams, sobald sie sich auf ihre Schnittstellen geeinigt haben, diese zu 100 % unabhängig von den anderen entwickeln, dokumentieren und gründlich testen. Auf diese Weise können die Teams parallel vorgehen und Funktionen implementieren, die zu 0 % miteinander kollidieren können.
  • Die Teams werden ausserdem ermutigt, die Programmiersprache zu wählen, die am besten zu der jeweiligen Aufgabe passt, die ihr Microservice erfüllen muss.
  • Da es sich per definitionem um „Mikro“-Dienste handelt, sind sie so konzipiert, dass sie schnell gestartet und wieder beendet werden können, so dass sie nur bei Bedarf eingreifen und das gesamte System effizienter und reaktionsfähiger machen.
  • Die Grösse von Microservices ermöglicht auch eine höhere Verfügbarkeit, da es möglich ist, viele von ihnen hinter einem Load Balancer zu haben; sollte eine Instanz eines Microservices ausfallen, kann sie schnell entlassen werden und eine neue an ihrer Stelle instanziiert werden, ohne dass die Verfügbarkeit verloren geht.
  • Systeme können schrittweise aktualisiert werden, wobei jedes Team Fehler behebt und Funktionen hinzufügt, ohne die anderen zu stören. Solange die Schnittstellen beachtet (und schliesslich versioniert) werden, gibt es keinen Grund, dass das System unter den Aktualisierungen leidet.

Es gibt jedoch viele Gründe, sich nicht für die Microservices-Architektur zu entscheiden; unter den wichtigsten sind:

  • Leistung: Ein mit Microservices aufgebautes System muss die Latenz zwischen diesen Diensten berücksichtigen; und in dieser Hinsicht sind monolithische Anwendungen schneller; ein Funktionsaufruf ist immer schneller als ein Netzwerkaufruf.
  • Reife des Teams: Microservices erfordern von den Teams ein gewisses Mass an Erfahrung und Fachwissen; bei Teams, die neu im Bereich Microservices sind, ist die Wahrscheinlichkeit eines Projektfehlschlags höher.
  • Kosten: Die Erstellung eines Microservices-Systems ist, wenn überhaupt, teurer, da jeder einzelne Dienst einen Overhead verursacht.
  • Machbarkeit: Manchmal ist es einfach nicht möglich, Microservices zu nutzen, zum Beispiel wenn es um Altsysteme geht.
  • Teamstruktur: Dies ist ein entscheidender Faktor, auf den wir später noch ausführlich eingehen werden.
  • Komplexität: Es ist nicht ungewöhnlich, dass Systeme aus Tausenden von gleichzeitigen Diensten bestehen, und dies führt zu Herausforderungen, auf die wir später noch eingehen werden.

Ich möchte nun auf die letzten beiden Punkte eingehen, die unserer Erfahrung nach die grössten Probleme bei Microservice-Implementierungen darstellen: Teamstruktur und die Wahrnehmung und Bewältigung von Komplexität.

Conway’s Law

Einer der entscheidenden Faktoren, der die Fähigkeit von Teams zur Implementierung von Microservices einschränkt, ist oft unsichtbar und wird übersehen: Ihre eigene Struktur. Auch dieses Phänomen ist nicht neu. Im Jahr 1968 schrieb Melvin A. Conway für die Zeitschrift Datamation einen Artikel mit dem Titel „How Do Committees Invent?“, in dem die folgende Idee hervorsticht:

Die Grundthese dieses Artikels ist, dass Organisationen, die Systeme entwerfen (…), gezwungen sind, Designs zu produzieren, die Kopien der Kommunikationsstrukturen dieser Organisationen sind.

Melvin Conway, Quelle.

Dafür gibt es umfangreiche Belege, sowohl anekdotische als auch empirische, die durch die Forschung belegt sind.

Die Konsequenz dieses Prinzips ist die folgende: Die Entscheidung zwischen einer monolithischen und einer Microservices-Architektur ist bereits im hierarchischen Diagramm einer jeden Organisation verankert.

Eine der Dienstleistungen, die wir bei VSHN anbieten, befasst sich genau mit diesem Thema. In unserem „DevOps-Enablement-Workshop“ bewerten wir den Grad der Agilität von Organisationen sowie das Ausmass und die Verbesserungen, die DevOps bringen könnte. Auf der Grundlage dieser Informationen führen wir ein Reverse-Engineering ihrer Struktur durch das Conway’sche Gesetz durch, um einen Ausgangspunkt für ihre digitale Transformation zu finden.

Komplex vs. Kompliziert

Ein weiterer wichtiger Punkt ist die Unterscheidung zwischen „komplex“ und „kompliziert“, da diese beiden Wörter in der Alltagssprache manchmal miteinander verwechselt werden können, und um die Sache noch schwieriger zu machen, kann das Wort „einfach“ als Antonym für beide verwendet werden.

„Komplex“ kommt aus dem Lateinischen complexus und bedeutet „aus ineinander verschlungenen Elementen bestehend“. Complexus ist wiederum von plectere („biegen, verflechten“) abgeleitet. Dieses Wort wird seit dem XVI. Jahrhundert verwendet, um etwas zu bezeichnen, das sich aus heterogenen Elementen zusammensetzt. Es hat dieselbe Wurzel (plectere) wie der medizinische Begriff „Plexus“, der „Geflecht“ bedeutet und seit dem 16. Jahrhundert als medizinischer Begriff für „Nerven- oder Blutgefässnetz“ verwendet wird.

(Quelle: Dictionnaire historique de la langue française von Alan Rey)

„Kompliziert“ hingegen hat einen ähnlichen Ursprung, aber eine andere Konstruktion: Es kommt vom lateinischen complicare, was wörtlich „zusammenfalten“ bedeutet. Im übertragenen Sinne wurde dies als Nähe zum Begriff der Peinlichkeit oder Unbeholfenheit verstanden. Das Wort setzt sich aus dem Wort plicare zusammen, das „falten“ bedeutet. Uhren, die gemeinhin als „Komplikationen“ bezeichnet werden (wie das Kaliber 89 von Patek Philippe, die Aeternitas Mega von Franck Muller und die „Référence 57260“ von Vacheron Constantin), sind per Definition komplizierte Maschinen.

Kurz gesagt, „komplex“ und „kompliziert“ stammen von leicht unterschiedlichen Wurzeln ab: Der lateinischen Wurzel plectere („verflechten“) für Ersteres und plicare („falten“) für Letzteres. Der Begriff „kompliziert“ vermittelt die Vorstellung eines Netzes von miteinander verflochtenen Objekten, deren Zustand und Verhalten sich durch die Interaktion mit anderen Objekten in diesem Netz ständig ändert. Das Wort kompliziert impliziert eine inhärente scheinbare „Unklarheit“ durch Faltung in sich selbst, die zu einem „sich entfaltenden“ Entdeckungsprozess einlädt.

Oder anders ausgedrückt: einzelne Microservices sollten nicht kompliziert sein, aber eine Microservice-Architektur ist per Definition komplex. Monolithen hingegen neigen dazu, mit der Zeit sehr kompliziert zu werden. Und natürlich sind beide nicht einfach.

Die Geschichte zeigt, dass Softwareentwickler ein leidenschaftliches Verhältnis zur Kompliziertheit haben; komplizierte Systeme sind grossartig, um auf Hacker News damit zu prahlen, während Maintainer auch privat über sie weinen.

Eine „Best Practice“ hat in diesem Zusammenhang eine und nur eine grundlegende Aufgabe: den Ingenieuren zu helfen, das Komplizierte in das Komplexe zu übersetzen. Die meisten softwarebezogenen Katastrophen werden durch eine einfache Tatsache verursacht: Aufgrund von Fristen, Organisation, Werkzeugen oder schlichtweg Unwissenheit neigen Softwareentwickler dazu, komplizierte statt komplexe Systeme zu bauen.

Dies ist ein weiterer Punkt, um den wir uns in unserem DevOps-Workshop kümmern, und zwar durch die Bewertung der aktuellen Ressourcen (nicht nur Quellcode, sondern auch aktuelle Datenbankschemata, Sicherheitsanforderungen, Netzwerktopologien, Bereitstellungsverfahren und -rhythmen usw.).

Migrieren oder umschreiben? Gleichgewicht

Die Kompliziertheit von Monolithen an sich ist nicht problematisch; sie führt zu eng gebundenen Systemen, die in der Regel sehr schnell sind, da, wie gesagt, ein Funktionsaufruf schneller ist als ein Netzaufruf. Schliesslich haben wir in der Vergangenheit sehr erfolgreich Monolithen gebaut. Aber die Erfahrung zeigt, dass sie in Bezug auf Verfügbarkeit und Skalierbarkeit Probleme bereiten. Microservices stellen einen diametral entgegengesetzten Ansatz dar, der eher auf Komplexität als auf Kompliziertheit beruht, der aber diese Probleme löst.

Es besteht also ein Spannungsverhältnis zwischen Komplexität und Kompliziertheit auf der einen und organisatorischen Zwängen auf der anderen Seite. Mit anderen Worten, es besteht ein Spannungsverhältnis zwischen monolithischen und Microservices-Systemen auf der einen Seite und mehr oder weniger hierarchischen Strukturen auf der anderen Seite. Ein Gleichgewicht zwischen diesen Kräften zu erreichen, ist also die technische Herausforderung, der sich Softwarearchitekten heutzutage stellen müssen.

Viele Teams stehen heute vor der Aufgabe, ihre Monolithen auf Microservice-basierte Architekturen zu migrieren, entweder auf Wunsch des Managements oder auf Grund von Kunden- oder Lieferantenanforderungen. Architekten können zum Glück einige Techniken anwenden, um ein Gleichgewicht zu finden:

  1. Beginne den Migrationspfad im Bewusstsein, dass oft nicht die gesamte Anwendung auf Microservices umgestellt werden muss. Einige Teile können und sollten monolithisch bleiben, und insbesondere bewährte ältere Systeme, auch wenn sie in COBOL oder älteren Technologien geschrieben wurden, können immer noch einen Wert darstellen und eine sehr wichtige Rolle für den Erfolg des Übergangs spielen.
  2. Identifiziere die Komponenten richtig, so dass sie im isolierten Zustand weder nur funktions-, noch nur daten-, noch nur anforderungsgesteuert sind, sondern von diesen drei Faktoren (Funktionalität, Daten und Anforderung) gleichzeitig gesteuert werden. Achte auf das Organigramm und verwende dieses als Grundlage für die Dekomposition in Microservices.
  3. Denke daran, dass die Netzwerkbandbreite nicht unbegrenzt ist. Einige Schnittstellen sollten „klobig“ sein, während andere „gesprächig“ sein sollten. Plane von Anfang an Latenzprobleme ein.
  4. Reduziere die Kommunikation zwischen den Dienststellen so weit wie möglich, was auf verschiedene Weise geschehen kann:
    1. Konsolidierung der Dienste
    2. Konsolidierung von Datendomänen (Kombination von Datenbankschemata oder Verwendung gemeinsamer Caches)
    3. Verwendung von Technologien wie GraphQL zur Verringerung der Netzwerkbandbreite
    4. Verwendung von Messaging-Warteschlangen, wie RabbitMQ.
  5. Einführung von Microservice-freundlichen Technologien wie Docker-Container, Kubernetes, Knative oder Red Hat OpenShift und Quarkus.
  6. Implementiere eine automatisierte Teststrategie für jeden einzelnen Microservice.
  7. Standardisiere Technologie-Stacks rund um Container und Kubernetes und schaffe eine gemeinsame Basis für ein echtes Microservice-Ökosystem in Unternehmen.
  8. Automatisiere die Arbeit so weit wie möglich, da sich der Aufwand für die Automatisierung (DevOps, CI/CD) über viele Dienste hinweg amortisieren kann und sich somit langfristig als Nettoinvestition erweist.

Wie bereits erwähnt, helfen wir Organisationen regelmässig bei ihrer digitalen Transformation in Richtung Microservices, Kubernetes, OpenShift, DevOps, CI/CD, GitLab und DevOps im Allgemeinen, um ihre Teams mit den Werkzeugen zu unterstützen, die sie in der Zukunft benötigen werden. In Anlehnung an das Konzept der Team-Topologien von Henny Portman kann VSHN sowohl als „Enabling Team“ (DevOps-Workshops, Beratung) als auch als „Platform Team“ (Kubernetes/OpenShift) unterstützen, um Microservices zu entwickeln und Stabilität und Sicherheit zu gewährleisten.

Schlussfolgerung

Microservice-Architekturen sind nicht nur ein Hype, sondern bringen auch grosse Vorteile mit sich, können aber auch eine grosse Herausforderung für Software-Teams darstellen.

Der beste Weg, diese Herausforderungen zu bewältigen, besteht darin, das Conway’sche Gesetz umzukehren und zunächst die menschliche Organisation deiner Teams zu analysieren. Mach sie unabhängig, agil und frei in der Wahl der besten Werkzeuge für ihre Arbeit. Ermutige sie, untereinander die Schnittstellen ihrer jeweiligen Komponenten auszuhandeln.

Lass uns komplexe, nicht komplizierte Systeme schaffen und betreiben. Wir können uns nicht von der Komplexität lösen; das ist unsere Aufgabe als Ingenieure. Aber wir können den komplizierten Teil loswerden.

Abschliessend möchte ich meinen ehemaligen Kollegen und lebenslangen Freund Adam Jones, einen unabhängigen IT-Berater aus Genf, zitieren: Um mit der Microservice-Architektur Erfolg zu haben, musst du Struktur in deine Aktivitäten einbetten und sie aus der Hierarchie entfernen. Es geht nicht darum, die Struktur verschwinden zu lassen, sondern sie dorthin zu verlagern, wo sie am meisten Nutzen bringt.

Aarno Aukia

Aarno ist Mitgründer der VSHN AG und als CTO für die technische Begeisterung zuständig.

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Allgemein Tech

Die 5 hartnäckigsten Mythen über Container-Technologien

28. Sep. 2021

Gastbeitrag von Richard Zobrist, Head of Partners & Alliances Switzerland, Red Hat.

Open-Source-Container-Technologien sind eine wichtige Massnahme, um Daten zu schützen. Trotzdem halten manche Unternehmen Containerlösungen vermeintlich für zu unsicher, zu schwierig zu integrieren, zu langsam oder gänzlich unnötig. Höchste Zeit, mit diesen hartnäckigen Mythen aufzuräumen.

1. Zu wenig Sicherheit

Für Sicherheitsteams wird es immer schwieriger, mit den sich ändernden Risiken, Compliance-Anforderungen, Tools und Architekturänderungen Schritt zu halten, die durch neue Technologien wie Container, Kubernetes, softwaredefinierte Infrastruktur und Cloud-Technologien eingeführt werden.

Um langfristig erfolgreich zu sein, müssen Sicherheitsexperten ihre Einstellung zu Containern jedoch ändern: Sie sind keine Virtual Machines (VMs) oder Hosts und bringen veränderte Sicherheitsherausforderungen mit sich die mit herkömmlichen Tools nicht bewältigt werden können. Die Red Hat OpenShift Container Platform ermöglicht den Anwendern, Open-Source-Vorteile mit der Stabilität und Sicherheit eines verwalteten Produkts zu kombinieren. Zudem bietet Red Hat OpenShift langfristig konsistentere Sicherheit, integrierte Überwachung, zentralisierte Richtlinienverwaltung und Kompatibilität mit Kubernetes Workloads. Red Hat OpenShift kann die Sicherheit erhöhen durch schnellere Software-Updates, die Sicherheitslücken schliessen – und dies ohne dass Sie dabei aktiv beteiligt sein müssen.

2. Zu schwierig zu integrieren

Ein weiterer Mythos, der sich unbeirrt hält, ist die „schwierige Integration“ von Open-Source-Anwendungen. Die Erklärung hierfür sei, dass heutige IT-Landschaften oftmals wenige Schnittstellen anböten, an die Open-Source-Plattformen andocken könnten. In einer diesjährigen, von der Universität Bern publizierten “Open Source Studie Schweiz” wird jedoch als Hauptgrund für den Einsatz von offener Software gerade die offenen Standards, die Open Source zugrunde liegen, genannt. Dies zeigt, dass Interoperabilität heute zentral ist und monolithische IT-Systeme ausgedient haben. Von Business-Anwendungen werden offene Schnittstellen via Application Programming Interfaces erwartet, über die etwa Microservices-Daten ausgetauscht werden könnten.

3. Mangel an Know-how

Viele Unternehmen haben eine gemeinsame Sorge: Wie können sie von Open-Source-Technologien profitieren, auch wenn sie über keine eigenen Fachkräfte verfügen? Welche Lösungen gibt es konkret? Und welche Hürden gilt es zu überwinden? Um Ihre Anwendungen auf Red Hat OpenShift zu migrieren, benötigen Sie kein zusätzliches Personal. Sie können entweder direkt mit Red Hat zusammenarbeiten oder die Migration einem zertifizierten Partner – wie etwa VSHN – überlassen.
Red Hat OpenShift bietet Ihnen den zusätzlichen Vorteil, dass im Hintergrund eine tatkräftige und hilfsbereite Community bereitsteht, mit welcher Wissen und Erfahrungen ausgetauscht werden können. In der dynamischen IT-Welt ist dieser Zugang zu kompetenten Fachleuten einer der wichtigsten Gründe für den Einsatz von Open-Source-Software. Ausserdem schafft die Verbreitung von Open-Source-Know-how auch die Grundlage für professionellen Support und letztlich die Möglichkeit, erfahrene Open-Source-Fachleute auch direkt anstellen zu können. So wird Open Source zu einem Trumpf im Kampf um IT-Talente, denn die Technologie macht Unternehmen für sie attraktiv.

4. Alle Anwendungen müssen auf Open Source basieren

Immer mehr Unternehmen transformieren ihr Geschäft, indem sie DevOps-Prinzipien, Microservices, und Container-Technologien wie Kubernetes anwenden. Red Hat OpenShift wird dennoch häufig unterstellt, dass es zu wenige Schnittstellen zu anderen Systemen aufweise und nur dann erfolgreich sei, wenn alle Anwendungen auf Open-Source-Technologien basierten. Aus der “Open Source Studie Schweiz” geht hingegen hervor, dass ein wichtiger Grund für die Nutzung von Red Hat OpenShift ist die enorme Auswahl an frei verfügbaren Komponenten und Tools ist. In den letzten Jahren hat sich rund um OpenShift ein signifikantes Ökosystem gebildet, von welchem die Kunden auf einfachste Weise profitieren können.
Da sich IT-Entscheidungen oft an dem orientieren, was andere tun, multipliziert sich mit der steigenden Verbreitung von Open-Source-Software deren Popularität.

5. Unklares Geschäftsmodell der Anbieter

Um auch diesem Mythos ein Ende zu setzen, lohnt sich ein Blick zurück zu den Anfängen von Open-Source-Technologien. Ein Meilenstein in der Open-Source-Geschichte war die Publikation der ersten Version des Linux-Kernels durch den finnischen Informatiker Linus Torvalds. Mit der Erfindung von Linux gelang es Torvalds, das erste komplett freie Betriebssystems für Computer zu entwickeln und er legte damit den Grundstein nicht nur für eine grosse Entwickler-Community, sondern auch für zahlreiche Projekte und Distributionen, die auf dem Linux-Kernel aufbauen, etwa “Red Hat Enterprise Linux”. In der Folge nahmen die Verbreitung und der Bekanntheitsgrad von Linux und anderer freier Software in der Unternehmenswelt stetig zu, ob es sich nun um Software für Server, Büroprogramme für Desktop-PCs oder Virtualisierungs-Tools für Cloud-Plattformen handelt.

In der Zwischenzeit hat Open Source seinen Ruf als Innovationstreiber für die Softwareindustrie gefestigt. Die Trends, die nun unsere Arbeit immer mehr bestimmen, basieren alle auf Open Source. Hierzu zählen Red Hat Enterprise Linux, Cloud Computing, Edge-Technologie und Internet of Things (IoT), Container, Künstliche Intelligenz (KI) und Maschinelles Lernen (ML) sowie DevOps. Heute ist Red Hat der weltweit führende Anbieter von Enterprise-Open-Source-Lösungen. Das Unternehmen beschäftigt weltweit etwa 18’000 Mitarbeiter und verfügt über 105 Büros, die sich auf sämtlichen Kontinenten befinden.

Zusammenarbeit mit VSHN

Mit der Initiative „Leading with Containers“ unterstützt Red Hat sowohl seine eigenen Kunden wie auch seine Partner bei der Einführung von „Red Hat OpenShift“. Kunden, die über einen Partner – wie etwa VSHN – von Red Hats Container-Technologie profitieren wollen, erhalten die gleichen Vorteile wie Red Hats eigene Kundschaft. Denn VSHN ist seit über 3 Jahren ein anerkannter Advanced Partner von Red Hat, der sich auf den Bereich „Certified Cloud & Service Provider“ (CCSP) spezialisiert.

Richard Zobrist

Head of Partners & Alliances Schweiz und (interimistischer) Country Manager Österreich bei Red Hat

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Tech

Bewertung der Auswirkungen neuer Docker-Pull-Rate-Limits in APPUiO

3. Nov. 2020

Docker Inc., das Unternehmen, welches hinter Docker Hub steht, hat vor kurzem eine Beschränkungen der Image-Pull-Rate für Benutzer von Docker Hub angekündigt. Diese Änderung betrifft alle Cloud Native Installationen, die so konfiguriert sind, dass sie Container Images verbrauchen, welche in Docker Hub gespeichert sind, einer der populärsten Container Registries. Diese Massnahme hat direkte Auswirkungen auf den Einsatz vieler Kundenanwendungen, die derzeit auf APPUiO Public und privaten Clustern laufen.

Wir verfolgen die Situation aufmerksam. Nach den jüngsten Ankündigungen beginnt der Docker Hub langsam damit, eine Begrenzung der Abrufrate auf 100 Abrufe pro 6 Stunden für anonyme (nicht authentifizierte) IP-Adressen und 200 Abrufe pro 6 Stunden für authentifizierte kostenlose Benutzer durchzusetzen. Dies bedeutet, dass ein gesamter Kubernetes- oder OpenShift-Cluster ohne authentifizierung für alle seine Benutzer nur 100 Container Images in 6 Stunden von Docker Hub abrufen kann. Während Wartungsperioden werden üblicherweise die meisten Container Images eines Clusters abgerufen. Eine Reduzierung der Limite für die Abrufrate kann aus diesem Grund zu Ausfallzeiten führen.

Diese Situation sollte das heutige Wartungsfenster nicht beeinträchtigen. Obwohl die Beschränkung der Abrufrate am Montag, dem 2. Oktober 2020 angekündigt wurde, zeigt eine Analyse der „Responses“ von Docker Hub, dass die neuen Begrenzungen noch nicht angewendet wurden. Diese werden nur während eines 3-Stunden-Fensters von 18:00 bis 21:00 Uhr (MEZ) morgen durchgesetzt . Leider wissen wir zu diesem Zeitpunkt noch nicht, wann die neuen Pull-Rate-Limits vollständig durchgesetzt werden.

Bemerkenswert ist auch, dass diese Einschränkungen weder für die interne OpenShift-Registry gelten die in APPUiO Public oder Private enthalten ist und die völlig unabhängig vom Docker Hub ist, noch für Docker-Benutzer mit Pro- oder Team-Konten. Authentifizierte Benutzer mit Pro- oder Team-Konten können unbegrenzt Daten von und zum Docker Hub übertragen.

VSHN evaluiert derzeit Massnahmen, um Ausfallzeiten zu verhindern und die Auswirkungen dieser Situation für unsere Kunden zu reduzieren. Die derzeit geeignetste Lösung besteht in der Umstellung auf die oben genannten Pro- oder Team-Docker-Kontoarten. Noch einfacher ist die Verwendung eines authentifizierten Benutzerkontos als Pull Secret anstelle eines anonymen Kontos, das die Pull-Rate-Grenze verdoppelt und das Risiko von Ausfallzeiten erheblich verringern könnte. Eine andere Möglichkeit besteht darin, Container Images in ein anderes öffentliches Register zu migrieren, wie z.B. Red Hat Quay. Eine andere Möglichkeit ist die Verwendung eines privaten Registers, wie AWS ECR, GitLab Container Registry, Harbor oder andere ähnliche Technologien. Insbesondere hat AWS kürzlich die zukünftige Verfügbarkeit („innerhalb von Wochen“) eines kostenlosen öffentlichen Registers angekündigt.

Bei Fragen dürfen Sie uns gerne kontaktieren.

Gabriel Mainberger

Gabriel Mainberger ist ein DevOps-Ingenieur bei VSHN.

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Allgemein Tech

OpenShift-Migration: auf OpenShift, zwischen Clustern und wieder weg

9. Okt. 2020

Update, September 2026: Dieser Artikel handelte ursprünglich von der Migration von OpenShift 3 auf 4. Er deckt jetzt OpenShift-Migrationen allgemein ab, weil Leserinnen und Leser genau danach suchen. Der Wechsel von 3 auf 4 steht weiter unten.

Die meisten, die nach einer OpenShift-Migration suchen, wechseln nicht die Version. Sie holen eine Anwendung von reinem Kubernetes auf OpenShift, fassen Cluster zusammen, oder überlegen, ob sie OpenShift wieder verlassen. Dieser Artikel deckt alle drei Fälle ab, den Wechsel von 3 auf 4 eingeschlossen.

Was OpenShift ist, in einem Absatz

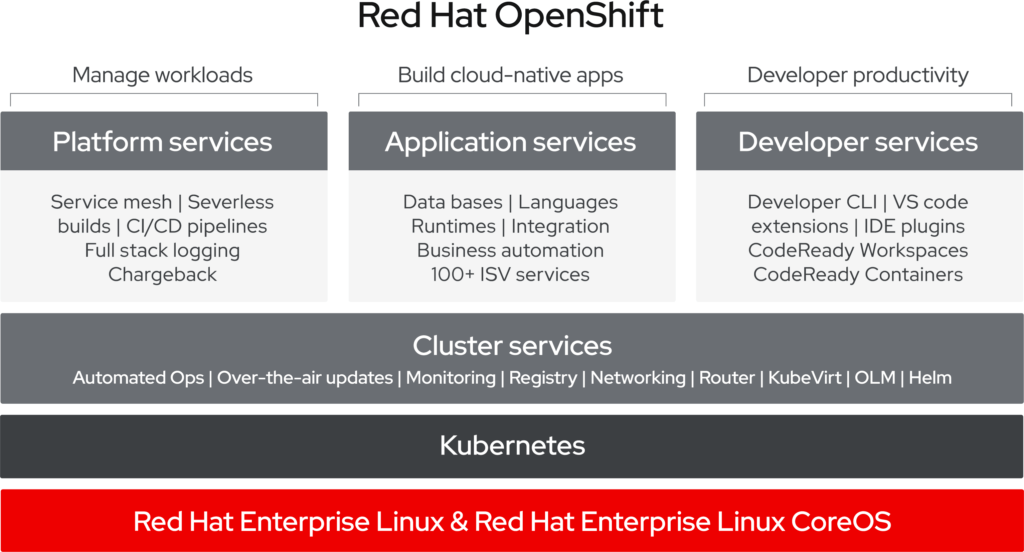
Red Hat OpenShift ist eine Kubernetes-Distribution: Kubernetes plus die Teile, die jeder produktive Cluster ohnehin braucht, gemeinsam gepflegt und von Red Hat unterstützt. Dazu gehören die Container-Runtime, eine Image-Registry, Build-Werkzeuge, Monitoring, Logging und ein klarer Ansatz für Security. Den ausführlichen Vergleich findest du unter was eine Kubernetes-Distribution ist, und die kurze Fassung unter warum OpenShift.

(Bild: © Red Hat https://www.openshift.com/learn/what-is-openshift)

Von Kubernetes auf OpenShift migrieren

Deine Manifeste laufen grösstenteils weiter. Deployments, Services, ConfigMaps und PersistentVolumeClaims sind dieselben API-Objekte. Was sich ändert, ist alles drum herum.

Security Context Constraints. Das ist der Punkt, der Teams überrascht. OpenShift führt Container standardmässig nicht als root aus, und ein Helm-Chart, das nie einen User deklariert hat, startet nicht. Die Lösung ist in der Regel ein securityContext im Chart und nicht eine privilegierte SCC im Cluster. Diese Änderung lohnt sich sauber gemacht.

Routes und Ingress. OpenShift hat ein eigenes Route-Objekt und akzeptiert ebenso Standard-Ingress. Bei Ingress zu bleiben ist die portable Wahl, und die empfehlen wir, solange du keine Route-Funktion konkret brauchst.

Builds und Registries. Wenn du Images im Cluster baust, bringt OpenShift BuildConfigs und eine interne Registry mit. Wenn deine Pipeline anderswo baut, lass sie dort: nichts zwingt dich in die Werkzeuge des Clusters.

Operators. Der grösste Teil der Plattform wird von Operators verwaltet, auch ihre eigenen Komponenten. Day-2-Arbeit, die du auf Kubernetes selbst skriptest, etwa Updates und Backups, übernimmt hier oft ein Operator.

Eine Migration läuft dann ungefähr so ab: Workloads inventarisieren, danach einordnen, wie stark sie sich gegen die Punkte oben sperren, den Ziel-Cluster aufsetzen, die zustandslosen Workloads verschieben, die Daten verschieben, DNS umstellen. Der spannende Teil sind nie die Manifeste, sondern die Daten und die Umstellung.

Zwischen OpenShift-Clustern migrieren

Cluster zusammenfassen, in eine andere Cloud ziehen, oder einen Cluster verlassen, dessen Version aus dem Support gefallen ist. Red Hat liefert Werkzeuge, die sowohl die Kubernetes-Ressourcen als auch die Inhalte der Persistent Volumes verschieben, mit Object Storage als Zwischenstation. Welches Werkzeug das gerade ist, hat mehrfach gewechselt: schau darum in die Dokumentation von Red Hat statt in einen Artikel.

Von OpenShift 3 auf OpenShift 4 migrieren

Einen direkten Upgrade-Pfad von 3 auf 4 gibt es nicht: die Plattform wurde neu gebaut, und der Wechsel ist eine Migration auf einen neuen Cluster.

  1. Einen neuen Cluster mit OpenShift 4 aufsetzen.
  2. Ihn so konfigurieren, wie der alte es bereitgestellt hat.
  3. Einen Migrationsplan schreiben, inklusive Umgang mit den Daten jeder Anwendung.
  4. Den Plan ausführen, Anwendung für Anwendung.
  5. DNS oder Load Balancer auf den neuen Cluster umstellen.

Geh vorher Storage, Netzwerk, Logging, Security und Monitoring durch: dort unterscheiden sich die beiden Versionen. OpenShift 3 ist seit 2021 aus dem Support. Wenn du noch darauf läufst, ist die Frage also nicht ob, sondern wohin.

Von OpenShift weg migrieren

Auch danach wird gesucht, und die Frage ist berechtigt. Wenn die Lizenzkosten von OpenShift nicht dem entsprechen, was du davon nutzt, passt reines Kubernetes mit einer verwalteten Control Plane womöglich besser. Dieselbe Portabilität, die den Weg hinein möglich macht, macht auch den Weg hinaus möglich. Aufgeben musst du das, was du bisher mitbekommen hast: die unterstützten Integrationen, die Security-Voreinstellungen, einen einzigen Ansprechpartner für den ganzen Stack. Das baust und pflegst du danach selbst.

Wir sagen es dir, wenn das für dich die bessere Antwort ist. Wir betreiben beides.

Wo VSHN hilft

VSHN ist Red Hat Premier Certified Cloud & Service Provider (CCSP) und betreibt seit 2016 Managed OpenShift unter der Marke APPUiO, on-premises und in der Cloud deiner Wahl. Wir machen die Migration und danach den Betrieb rund um die Uhr. Die Leute, die den Wechsel planen, tragen also auch das Ergebnis.

Wie so ein Wechsel in einem regulierten Umfeld aussieht, beschreibt die Success Story der acrevis Bank.

Wo du OpenShift betreiben kannst

Wir betreiben es auf zwei Arten: als dediziertes Managed OpenShift auf deinem eigenen Cluster, on-premises oder in der Cloud deiner Wahl, und als geteilte Public-Cloud-Plattform über APPUiO. Was passt, hängt davon ab, wie viel vom Cluster du für dich allein brauchst.

Buche ein Gespräch, wir gehen deine Workloads durch und sagen dir, was der Wechsel konkret bedeutet.

Markus Speth

Marketing, Communications, People

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Allgemein Tech

Unser Weg zu Managed OpenShift 4

23. Sep. 2019

Red Hat OpenShift 4

Diesen Sommer hat Red Hat OpenShift 4 veröffentlicht. Auf den ersten Blick handelt es sich bei der neuen Major Version um eine stetige Weiterentwicklung von OpenShift 3 mit relativ überschaubaren Änderungen für den Anwender. Schaut man jedoch unter die Haube, dann erkennt man schnell ein vollständig überarbeitetes OpenShift. Der Blogpost von Benjamin Affolter auf dem APPUiO Blog untersucht die Änderungen von OpenShift 4 und beschreibt sie im Detail.

Mit dem nachfolgenden Artikel möchten wir hinter die Kulissen unseres Managed OpenShift Angebotes schauen und erklären, was wir alles zu tun haben, um unseren Managed Service mit OpenShift 4 anbieten zu können.

Vorteile von OpenShift 4

Red Hat verspricht mit Version 4 von OpenShift unter anderem folgende Verbesserungen:

  • Neuer Installer
  • Komplett automatisierte Operations, Wartung und Konfiguration mittels Operators
  • Integration von Operator Hub
  • Aktuelle Versionen von Kubernetes

Um die Vorteile und auch Auswirkungen zu verstehen, müssen wir einen Schritt zurückgehen und uns OpenShift 3 anschauen.

Managed OpenShift 3 – Was ist alles dabei?

Zum Verständnis ein kurzer Überblick, was unser bisheriger Managed OpenShift 3 Service alles beinhaltet (nicht abschliessend):

  • Architektur Engineering und Aufbau des OpenShift Cluster auf nahezu beliebiger Infrastruktur (Cloud, On-Premise)
  • Monitoring aller Cluster-relevanten Komponenten zur Sicherstellung des Betriebs
  • Regelmässiges Backup der Cluster Konfiguration inkl. Sicherstellung der Integrität des Backups
  • Wöchentliche Wartung aller Systeme, Einspielung von Softwarepatches und Konfigurationsverbesserungen auf allen Clustern
  • Automatisierung aller Arbeiten mittels Ansible (Konfiguration, Wartung, Updates, Upgrades, Installation, Sanity Checks und vieles mehr)
  • Integration in unser zentrales Kundenportal für einen Überblick über den Zustand des Clusters und weiterer Funktionen
  • Umfangreiche Dashboards in Grafana
  • Enge Zusammenarbeit mit dem Red Hat Support u.a. zur Lösung von Bugs in OpenShift
  • Unterhalt diverser interner Lab Cluster um Änderungen an produktiven Clustern testen zu können
  • Bereitstellung von Persistentem Storage mittels Gluster
  • Management und Pflege des Betriebssystems Red Hat Enterprise Linux für die OpenShift Master und Nodes
  • Ausbildung von System Engineers um OpenShift betreiben zu können

Alle diese aufgelisteten Punkte sind seit der allerersten Version von OpenShift 3 entwickelt worden und werden täglich von unseren VSHNeers weiterentwickelt.

Status Quo VSHN Systeme

Aus technischer Sicht sieht unsere heutige Systemlandschaft in etwa so aus (Kurzübersicht):

  • Puppet für das lokale Betriebssystem Management aller VMs (Systemkonfiguration, Aufrechterhaltung des definierten Zustandes) und Inventarisierung aller Systeme und Services
  • Icinga2 fürs Monitoring aller Betriebssystem Parameter innerhalb der VM, aber auch sehr umfangreiche Checks aller OpenShift Cluster Komponenten. Icinga2 wird durch Puppet konfiguriert und orchestriert.
  • Ansible zur Installation und Konfiguration von OpenShift, zur regelmässigen Wartung und für vieles mehr
  • BURP für konsistente Datenbackups inkl. Cluster Konfiguration, konfiguriert und orchestriert durch Puppet
  • Gluster für Persistent Storage, verwaltet mittels Ansible

Über die Jahre haben sich unzählige Ansible Playbooks gesammelt und unser ganzes Wissen und die Automatisierung steckt in diesen Playbooks. Wir pflegen unseren eigenen Fork vom offiziellen OpenShift Ansible Repository, um schnell auf eventuelle Bugs reagieren zu können. Diesen Fork halten wir regelmässig auf dem aktuellen Stand mit Upstream.
Puppet kümmert sich nicht nur um die lokale Betriebssystem Konfiguration, sondern steuert auch viele wichtige Komponenten wie das Monitoring und Backup System. Zudem haben wir mittels der PuppetDB ein stets aktuelles Inventar aller von uns gemanagten Systeme inkl. detaillierter Versionsangaben der installierten Komponenten. Dies ist auch in unserem Kundenportal integriert und wird zur automatischen Verrechnung unserer Managed Services verwendet.
Die von uns entwickelten Monitoring Plugins für Icinga2 decken nahezu jedes von uns bis heute entdeckte Problem mit OpenShift ab und melden uns, wenn etwas mit dem Cluster oder einer Komponente davon nicht mehr in Ordnung sein sollte.
Unsere Systemdokumentation und die Anleitung zum Betrieb von OpenShift umfassen mehrere dutzend Wiki Artikel.

Managed OpenShift 4 – Was gibt es für VSHN zu tun?

Aus Sicht des System Engineering ist OpenShift 4 ein komplett neues Produkt. Für VSHN bedeutet das, dass wir einen grossen Teil der genannten Punkte vollständig neu entwickeln müssen.
Ein paar Beispiele:

  • Die Installation und Konfiguration von OpenShift 4 basiert nicht mehr auf Ansible, sondern auf einem eigenen Installer (benutzt im Hintergrund Terraform) und die Konfiguration geschieht mittels In-Cluster Operators. Unsere Ansible Playbooks für OpenShift 3 können zum grössten Teil nicht mehr für OpenShift 4 verwendet werden.
  • Als Betriebssystem kommt nicht mehr Red Hat Enterprise Linux zum Einsatz, sondern Red Hat CoreOS, dass sich komplett anders verhält. Puppet kann so nicht mehr eingesetzt werden und wie oben beschrieben müssen wir andere Wege finden für die Inventarisierung, Orchestrierung und Verrechnung der Umsysteme.
  • Unsere Monitoring Plugins für Icinga2 sind nicht mehr mit OpenShift 4 kompatibel und das Monitoring Konzept mit Icinga2 passt nicht mehr auf die überarbeitete Architektur der Plattform. Das bedeutet für uns eine Neuentwicklung unseres Monitoring Konzepts.
  • Das Backup System BURP kann nicht mehr in der heutigen Form eingesetzt werden, ein neues Backup System muss erarbeitet werden.

Dies ist keine abschliessende Liste, es gibt noch viele weitere Details in unserer Systemlandschaft, die angepasst werden müssen.

Der Weg in die Produktion

Für uns als Managed Service Provider ist Stabilität und Skalierbarkeit das A und O und keine Verhandlungssache. Das bedeutet, dass wir uns die notwendige Zeit nehmen müssen, um alle Änderungen und Eigenheiten für einen produktiven Betrieb von OpenShift 4 zu lernen. Die Anpassung und das Erarbeiten der notwendigen Tools und Prozesse für den Betrieb dutzender Cluster benötigt viel Zeit und Engineering Aufwand. Wir haben aber bereits früh begonnen und konnten schon erste Erfahrungen mit OpenShift 4 sammeln. Die Erfahrungen stimmen uns sehr zuversichtlich, dass OpenShift 4 seine Versprechen für einen stark vereinfachten Betrieb einhalten kann.
Die aktuelle Version OpenShift 4.1 hat aber auch noch ein paar Einschränkungen. Hier eine kleine Auswahl, was uns aufgefallen ist:

  • Kein Support für Proxies
  • AWS und VMware sind die einzigen unterstützten IaaS Provider mit OpenShift 4.1 (aktuelle Version zum Zeitpunkt dieses Artikels)
  • Installation auf nicht unterstützten und nicht-Cloud Plattformen ist sehr fragil
  • Container Storage nur über CSI

Viele IaaS Provider sind zum jetzigen Zeitpunkt noch nicht bereit für OpenShift 4. Wir stehen jedoch in engem Kontakt mit unseren IaaS & Cloud Partnern wie cloudscale.ch, Exoscale, Swisscom und AWS, um die Kompatibilität herstellen zu können, damit wir auch mit OpenShift 4 künftig einen reibungslosen Betrieb anbieten können.
OpenShift 4.1 erinnert uns teilweise an die Anfangszeiten von OpenShift 3, damals benötigte es auch einige Zeit, bis OpenShift 3 für den Produktivbetrieb bereit war.
Wir sind aber sehr zuversichtlich, dass die offenen Punkte noch gelöst werden können und freuen uns auf die 4. Generation von Red Hat OpenShift!

Weitere Infos

Unsere Freunde von Adfinis SyGroup haben in ihrem Blogpost „OpenShift 4 – Learnings aus der ersten produktiven Umgebung“ ihre ersten Erfahrungen mit OpenShift 4 beschrieben, dies deckt sich sehr gut mit unseren bisherigen Beobachtungen.
Wenn du mehr zum Thema OpenShift und Kubernetes erfahren willst, empfehlen wir dir unseren Artikel „Was ist eine Kubernetes Distribution und was sind die Unterschiede zwischen Kubernetes und OpenShift“ oder schau dir die Impressionen vom Red Hat Forum Zürich 2019 an, wo wir mit APPUiO wieder als Sponsor mit einem Stand vor Ort waren.

APPUiO – Swiss Container Platform

Mit APPUiO.ch haben wir eine auf Red Hat OpenShift basierende Schweizer Containerplattform geschaffen, auf der wir Managed Services als PaaS-Lösung (Platform-as-a-Service) auf beliebiger Infrastruktur anbieten können: public, dedicated, private und on-premises. Auf Basis bewährter Open Source Konzepte wie Docker und Kubernetes entwickelst, betreibst und skalierst du eine Anwendung nach deinen Bedürfnissen. Mit APPUiO können deine Applikationen sowohl auf Public Clouds als auch unternehmensintern betrieben werden. Die Plattform wurde 2015 von den beiden IT-Spezialisten Puzzle ITC und VSHN AG ursprünglich für die Professionalisierung der internen IT entwickelt. Heute wird APPUiO bereits von etlichen Kunden produktiv eingesetzt und wird von einer starken Community gestützt.

Wie können wir helfen?

Durch unsere Erfahrung im Betrieb von OpenShift Clustern rund um die Welt bieten wir Managed OpenShift Cluster auf nahezu jeder Public, Private oder On-Premise Cloud an. Wir helfen gerne bei der Evaluation, Integration und Betrieb und unterstützen mit unserer langjährigen Kubernetes Erfahrung. Kontaktiere uns, abonniere unseren Newsletter und folge uns auf Twitter (@vshn_ch und @APPUiO) oder wirf einen Blick auf unsere Services.
Wir freuen uns auf dein Feedback! 

Tobias Brunner

Tobias Brunner arbeitet seit über 20 Jahren in der Informatik und seit bald 15 Jahren im Internet Umfeld. Neue Technologien wollen ausprobiert und darüber berichtet werden.

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Tech

Go-Operator

18. Juni 2019

use create

deploye unsere Operatoren Schritt für Schritt.
Für diesen SDK-unterstützten Workflow bieten wir:

a) eine Beschreibung der generierten Operator-Struktur (es gibt eine für jeden spezifischen Workflow);

b) einen Link zu unseren Operator-Beispielen basierend auf einer solchen Operator-Struktur (es gibt eine für jeden spezifischen Workflow) und Logik.

c) Beschreibungen wie (z.B. 3rd-Party) Ressourcen, die sich vom Core Kubernetes Ressource-Typ unterscheiden, zum Operator hinzugefügt werden können

d) eine Beschreibung der wichtigsten Vor- und Nachteile der Verwendung einer solchen Operator-Struktur (es gibt eine für jeden spezifischen Workflow) und Logik.

a) Beschreibung der generierten Operator-Struktur (es gibt eine für jeden spezifischen Workflow)

Nachfolgend die Struktur eines generierten GO-Operators:

Datei/Ordner
Zweck
cmd
Enthält manager/main.go welches das Hauptprogramm des Operators ist. Dadurch wird ein neuer Manager instanziiert, der alle custom resource definitions unter pkg/apis/... registriert und alle Controller startet unter pkg/controllers/... .
pkg/apis
Enthält den Verzeichnisbaum, der die APIs der Custom Resource Definitions (CRD) definiert. Von den Benutzern wird erwartet, dass sie die Dateien pkg/apis/<group>/<version>/<kind>_types.go bearbeiten, um die API für jeden Ressourcen-Typ zu definieren und diese Pakete in ihre Controller importieren, um nach diesen Ressourcen-Typen zu suchen.
pkg/controller
Dieser pkg enthält die Controller-Implementierungen. Von den Benutzern wird erwartet, dass sie die Datei pkg/controller/<kind>/<kind>_controller.go bearbeiten, um die Abstimmungslogik der Steuerung für die Behandlung eines Ressourcen-Typs der angegebenen Art zu definieren.
build
Enthält das dockerfile und Build-Skripte, die zum Erstellen des Operators verwendet werden.
deploy
Enthält verschiedene YAML-Manifeste zur Registrierung von CRDs, zur Einrichtung von RBAC und zur Bereitstellung des Operators als Deployment.
Gopkg.toml Gopkg.lock
Die Go Dep Manifeste beschreiben die externen Abhängigkeiten dieses Operators.
vendor
Der golang vendor Ordner, der die lokalen Kopien der externen Abhängigkeiten enthält, die die Importe dieses Projekts erfüllen. Go Dep verwaltet den vendor direkt.

Operator scope

Ein namespace-scoped Operator (der Standard) überwacht und verwaltet Ressourcen in einem einzigen Namespace, während ein cluster-scoped Operator Ressourcen clusterweit überwacht und verwaltet. Namespace-scoped Operators werden wegen ihrer Flexibilität bevorzugt. Sie ermöglichen entkoppelte Upgrades, Namespace Isolation für Fehler und Überwachung sowie unterschiedliche API Definitionen. Es gibt jedoch Anwendungsfälle, in denen ein cluster-scoped Operator sinnvoll sein kann. So wird beispielsweise der cert-manager Operator häufig mit cluster-scoped Berechtigungen und Überwachungen eingesetzt, um die Ausstellung von Zertifikaten für einen ganzen Cluster zu verwalten.

b) Beispiele von Operator(en) basierend auf einer solchen Operator-Struktur (es gibt eine für jeden spezifischen Workflow) und Logik.

Wir diskutieren zwei Beispiele eines GO-Operators: 
1) Beispiel 1: Dieser Operator repliziert sich nur unter einem bestimmten Projekt
2) Beispiel 2: Dieser Operator erlaubt es, die Anzahl der Pods in einem Projekt zu manipulieren.

c) Wie 3rd Party Ressourcen (z.B. unterschiedlich zum Core Kubernetes Ressource-Typ) zum Operator hinzufügen

Der Operator-Manager unterstützt die Core Kubernetes Ressourcen-Typen, wie sie im client-go scheme („register.go„) Paket enthalten sind und registriert auch die Schemata aller benutzerdefinierten Ressourcen-Typen, die im Projekt definiert sind unter pkg/apis

import (
  "github.com/example-inc/memcached-operator-long/pkg/apis"
  ...
)
// Setup Scheme for all resources
if err := apis.AddToScheme(mgr.GetScheme()); err != nil {
  log.Error(err, "")
  os.Exit(1)
}

Um eine 3rd Party Ressource zu einem Operator hinzuzufügen, musst du sie zum managers scheme hinzufügen. Indem du eine AddToScheme Methode erstellst oder wiederverwendest, kannst du ganz einfach eine Ressource zu deinem Schema hinzufügen. Ein Beispiel zeigt, dass du eine Funktion definierst und dann mit dem runtime Paket nutzt, um einen SchemeBuilder zu erstellen.
Registriere dich mit dem Managers Schema
Rufe die AddToScheme() Funktion auf für deine 3rd Party Ressource und übergebe sie in das Manager-Schema über mgr.GetScheme().
Beispiel:

import (
    ....
    routev1 "github.com/openshift/api/route/v1"
)
func main() {
    ....
    if err := routev1.AddToScheme(mgr.GetScheme()); err != nil {
      log.Error(err, "")
      os.Exit(1)
    }
    ....
}

„Nachdem du deinem Operator-Projekt neue Importpfade hinzugefügt hast, führe dep ensure im root-Verzeichnis deines Projektes aus, um die Abhängigkeiten zu erfüllen.“.

$ dep ensure

d) Eine Beschreibung der wichtigsten Vor- und Nachteile bei der Verwendung dieser Operatorstruktur (es gibt eine für jeden spezifischen Workflow) und Logik;

Vorteile (+) und Nachteile (-):

(+) Es ist einfach zu bedienen und erstellt einen einfachen Operator.

Das Hauptprogramm für den Operator cmd/manager/main.go initialisiert und führt den manager aus. Der Manager registriert automatisch das Schema für alle custom resource definiert unter pkg/apis/... und führt alle Controller aus unter pkg/controller/....

Der Manager kann den Namespace einschränken, den alle Controller auf Ressourcen überwachen:

mgr, err := manager.New(cfg, manager.Options{Namespace: namespace})

Standardmässig ist dies der Namespace, in dem der Operator läuft. Um alle Namespaces zu sehen, lassen Sie die Option namespace leer:

mgr, err := manager.New(cfg, manager.Options{Namespace: ""})

(+) genügend klare Möglichkeit, Ressourcen von 3rd Parties (d.h. anders als die Core Kubernetes Ressourcen-Typen) zum Operator hinzuzufügen.

(-) es ist immer noch instabil/Änderungen der APIs und die zukünftigen Versionen davon könnten nicht unterstützt werden (wir beobachten diese Entwicklung und aktualisieren den Blogbeitrag entsprechend).

Damit der Operator funktioniert, mussten wir einige Issues in Github öffnen (die geschlossen und als Fehler eingestuft wurden):

https://github.com/operator-framework/operator-sdk/issues/651

https://github.com/operator-framework/operator-sdk/issues/927

https://github.com/operator-framework/operator-sdk/issues/1053

(-) Der Workflow zur Erstellung der GO-Operatoren erscheint etwas komplexer/unklar (Schritte in rot) als der mit Ansible und Helm generierte (die weniger Schritte erfordern):

  1. Erstelle ein neues Operator-Projekt mit Hilfe des SDK Command Line Interface (CLI).
  2. Definiere neue Ressource-APIs durch Hinzufügen von Custom Resource Definitions (CRD)
  3. Definiere Controller zur Überwachung und Abstimmung von Ressourcen
  4. Schreibe die Abstimmungslogik für deinen Controller mit Hilfe des SDK und Controller-Runtime APIs
  5. Verwende das SDK CLI Operator-Deployment-Manifest zum builden und generieren

Zurück zur Übersicht

Zurück zur Übersicht Abschnitt 3 – Beispiele für unterstützte Kubernetes Operatoren-SDK Workflows.

simon.beck

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Tech

Beispiele für unterstützte Kubernetes Operatoren-SDK Workflows

3. Apr. 2019

Dieser Blogbeitrag ist Teil der Serie Kubernetes Operatoren mit dem Operatoren SDK Framework entwickeln.
IN FRÜHEREN BLOG-POSTS HABEN WIR ÜBER DIE FOLGENDEN THEMEN GESPROCHEN:
Abschnitt 1 – Operatoren, Operatoren-Framework und Operatoren-SDK

  • Hier diskutieren wir in einem allgemeinen Rahmen über Operatoren, Operatoren-Framework und Operatoren-SDK.
  • Dann werden wir über das Operatoren-SDK diskutieren, das in GitHub immer beliebter wird und im Allgemeinen über den „Operatoren-SDK Workflow“, der für die Generierung und Handhabung von Operatoren verwendet wird.

Abschnitt 2 – Unterstützte Kubernetes Operatoren-SDK Workflows

  • Hier werden die drei verfügbaren alternativen Workflows zur Generierung von Operatoren erläutert, die von den letzten Versionen der Operatoren-SDK APIs bereitgestellt werden.
  • Wir besprechen auch Vor- und Nachteile der Nutzung der verschiedenen Operatoren-Workflows.

IN DIESEM BEITRAG SPRECHEN WIR ÜBER:
Abschnitt 3 – Beispiele für unterstützte Kubernetes Operatoren-SDK Workflows

  • Hier zeigen wir Beispiele für die drei verfügbaren alternativen Workflows zur Generierung von Operatoren, die von den Operatoren-SDK APIs bereitgestellt werden.
  • Wir konzentrieren uns speziell auf Go-Operatoren, da sie unserer Meinung nach die stabileren verfügbaren APIs sind.

Abschnitt 3 – Beispiele für unterstützte Kubernetes Operatoren-SDK Workflows

Wir werden folgendes anschauen:
1) Operator: Go-Operator
2) Operator: Ansible-Operator [in Kürze verfügbar]
3) Operator: Helm-Operator [in Kürze verfügbar]
 
Für jeden dieser SDK-unterstützten Workflows bieten wir:
a) eine Beschreibung der generierten Operator-Struktur (es gibt eine für jeden spezifischen Workflow);
b) einen Link zu unserem/unseren Beispiel(en) von Operator(en), die auf einer solchen Operator-Struktur basieren (es gibt eine für jeden spezifischen Workflow) und Logik.
c) Beschreibungen, wie man solche (3rd Party) Ressourcen hinzufügt, die sich von den Core-Kubernetes-Ressourcentypen unterscheiden, zu deinem Operator 
d) eine Beschreibung der wichtigsten Vor- und Nachteile der Verwendung einer solchen Operator-Struktur (es gibt eine für jeden spezifischen Workflow) und Logik.

Zurück zur Übersicht

Zurück zur Übersicht Kubernetes Operatoren mit dem Operatoren SDK Framework entwickeln.

simon.beck

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Tech

Unterstützte Kubernetes Operatoren-SDK Workflows

Dieser Blogbeitrag ist Teil der Serie Kubernetes Operatoren mit dem Operatoren SDK Framework entwickeln.
IN FRÜHEREN BLOG-POSTS HABEN WIR ÜBER DIE FOLGENDEN THEMEN GESPROCHEN:
Abschnitt 1 – Operatoren, Operatoren-Framework und Operatoren-SDK

  • Hier diskutieren wir in einem allgemeinen Rahmen über Operatoren, Operatoren-Framework und Operatoren-SDK.
  • Dann werden wir über das Operatoren-SDK diskutieren, das in GitHub immer beliebter wird und im Allgemeinen über den „Operatoren-SDK Workflow“, der für die Generierung und Handhabung von Operatoren verwendet wird.

IN DIESEM BEITRAG SPRECHEN WIR ÜBER:
Abschnitt 2 – Unterstützte Kubernetes Operatoren-SDK Workflows

  • Hier werden die drei verfügbaren alternativen Workflows zur Generierung von Operatoren erläutert, die von den letzten Versionen der Operatoren-SDK APIs bereitgestellt werden.
  • Wir besprechen auch Vor- und Nachteile der Nutzung der verschiedenen Operatoren-Workflows.

Abschnitt 2 – Unterstützte Operatoren-SDK Workflows

Wie bereits erwähnt, ist das Operator SDK auf GitHub ein sehr aktives Projekt, mit über 10 Releases, die in weniger als einem Jahr produziert wurden. Dies bedeutet, dass das Operator-SDK ein Toolkit ist, das sich im Laufe der Zeit weiterentwickelt (z.B. ändert sich sein Code, seine Struktur und Logik). Insbesondere, wie auf der Github-Hauptseite des Operator-SDK berichtet, sind die Bibliotheken und Tools mit „Projektstatus: pre-alpha“ gekennzeichnet und damit „signifikante Änderungen an der API in den kommenden Releases erwartet werden“.
Das Projekt startete im April 2018 und wir begannen es ab September 2018 intensiv zu beobachten. Wir haben herausgefunden, dass das SDK drei verschiedene Workflows zur Verfügung stellt, um Operatoren basierend auf Go, Ansible, oder Helm zu entwickeln.
Diese Versionen des Operators SDK sind zwischen 2018 und 2019 entstanden. Konkret basierte die erste Version des Operators auf Go und erst ab Dezember 2018 wurde eine Version auf Ansible bereitgestellt.
Schliesslich wurde Anfang 2019 (im Januar) auch der Operator-Workflow auf Basis von Helm freigegeben.
Somit bietet das SDK einen Workflow zur Entwicklung von Operatoren auf Basis von Go, Ansible, oder Helm.
Der folgende Workflow gilt für einen neuen Go-Operator:

      1. Erstelle ein neues Operator-Projekt mit Hilfe des SDK Command Line Interface (CLI).
      2. Definition neuer Ressourcen-APIs durch Hinzufügen von Custom Resource Definitions (CRD).
      3. Definition von Controllern zur Überwachung und Abstimmung von Ressourcen.
      4. Schreibe die Abstimmlogik für den Controller über das SDK und die Controller-Laufzeit-APIs.
      5. Verwende das SDK CLI, um die Operator Deployment Manifeste zu erstellen und zu generieren.

Der folgende Workflow gilt für einen neuen Ansible-Operator:

      1. Erstelle ein neues Operator-Projekt mit Hilfe des SDK Command Line Interface (CLI).
      2. Schreibe die Abstimmungslogik für das Objekt mit Hilfe von Ansible Playbooks und Rollen.
      3. Verwende das SDK CLI, um die Operator Deployment Manifeste zu erstellen und zu generieren.
      4. Optional kannst du mit Hilfe des SDK CLI weitere CRD’s hinzufügen und die Schritte 2 und 3 wiederholen.

Der folgende Workflow gilt für einen neuen Helm-Operator:

      1. Erstelle ein neues Operator-Projekt mit Hilfe des SDK Command Line Interface (CLI).
      2. Erstelle ein neues (oder füge ein bestehendes) Helm-Chart hinzu, das von der Abstimmungslogik des Operators verwendet wird.
      3. Verwende das SDK CLI, um die Operator Deployment Manifeste zu erstellen und zu generieren.
      4. Optional kannst du mit Hilfe des SDK CLI weitere CRD’s hinzufügen und die Schritte 2 und 3 wiederholen.

Richtlinien:
Command Line Interface: Um mehr über den SDK CLI zu erfahren, lese die SDK CLI Reference, oder führe operator-sdk [command] -h aus.
Eine Anleitung zu Reconcilers, Clients, und Interaktion  mit Ressourcen-Events, siehe Client API doc.
Wie aus der folgenden Abbildung ersichtlich, gibt es keinen grossen Unterschied zwischen den verschiedenen Operator-Workflows.
Der Workflow, der die höchste Reife erreicht hat und mehr Kontrolle über das Verhalten des Operator bietet, ist der auf Go basierende:

Nächster Artikel

Abschnitt 3 – Beispiele für unterstützte Operatoren-SDK Workflows

Zurück zur Übersicht

Zurück zur Übersicht Kubernetes Operatoren mit dem Operatoren SDK Framework entwickeln.

simon.beck

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Tech

Einführung in Kubernetes Operatoren, Operatoren-Framework und Operatoren-SDK

1. März 2019

Einführung in Kubernetes Operatoren, das Operatoren-Framework und Operatoren-SDK

Dieser Blogbeitrag ist Teil der Serie Kubernetes Operatoren mit dem Operatoren SDK Framework entwickeln.
Abschnitt 1 – Kubernetes Operatoren, Operatoren-Framework und Operatoren-SDK:

  • Hier diskutieren wir in einem allgemeinen Rahmen über Operatoren, Operatoren-Framework und Operatoren-SDK.
  • Dann werden wir über das Operatoren-SDK diskutieren, das in GitHub immer beliebter wird und im Allgemeinen über den „Operatoren-SDK Workflow“, der für die Generierung und Handhabung von Operatoren verwendet wird.

Abschnitt 1 – Kubernetes Operatoren, Operatoren-Framework und Operatoren-SDK:

a) Operatoren sind Kubernetes-Applikationen.
Eine Kubernetes-Applikation ist eine Applikation, die sowohl auf Kubernetes bereitgestellt als auch über die Kubernetes-APIs und kubectl-Tools verwaltet wird. Um Kubernetes optimal nutzen zu können, benötigst du eine Reihe zusammenhängender APIs, die erweitert werden müssen, um deine Kubernetes-Applikationen, zu warten und zu verwalten. Man kann sich Operatoren als die „Runtime vorstellen, die diese Art von Applikation auf Kubernetes verwaltet“.
Somit ist ein Operator eine Methode zum Packaging, Deployen and Verwalten einer Kubernetes-Applikation. Konzeptionell nimmt ein Operator menschliches Betriebswissen auf und kodiert es in Software, die leichter verpackt und mit den Consumern geteilt werden kann. Wir können uns einen Operator als eine Erweiterung des Engineering-Teams des Softwareanbieters vorstellen, der über die Kubernetes-Umgebung wacht und seinen aktuellen Zustand nutzt, um Entscheidungen in Millisekunden zu treffen. Operatoren folgen einem [Reifegradmodell] von der Basis- bis zur spezifischen Logik für eine Anwendung.
Wir haben in den letzten Jahren gesehen, dass sich die Fähigkeiten der Operatoren in ihrer Komplexität unterscheiden, je nachdem, wie viel Intelligenz in die Implementierungslogik des Operators selbst eingebracht wurde. Wir haben auch erfahren, dass die Erstellung eines Operators typischerweise mit der Automatisierung der Installations- und Self-Service-Funktionen einer Anwendung beginnt und sich dann weiterentwickelt, um je nach Anwendungsfall eine komplexere Automatisierung zu übernehmen. Daher sind fortgeschrittene Operatoren heute so konzipiert, dass sie Upgrades nahtlos handhaben, automatisch auf Ausfälle reagieren und keine Shortcuts nehmen, wie das Überspringen eines Software-Backup-Prozesses, um Zeit zu sparen.
b) Operatoren-Framework
Operatoren sind Kubernetes-native Applikationen, die die Verwaltung komplexer stateful Applikationen auf Kubernetes erleichtern, aber das Schreiben solcher Operatoren kann aufgrund von Herausforderungen wie (i) der Verwendung von Low-Level-APIs und (ii) mangelnder Modularität, die zu Duplication, Inkonsistenzen und unerwartetem Verhalten führt, sehr schwierig sein.
Um diesem Problem zu begegnen, werden derzeit mehrere Tools (z.B. das Operatoren-Framework, Kooper, Metacontroller, etc.) als Ergebnis jahrelanger Arbeit und Erfahrung der Red Hat, Kubernetes und CoreOS Open-Source-Communities bei der Erstellung von Operatoren eingeführt. Insbesondere Red Hat und die Kubernetes Open-Source-Community teilten sich das Operator Framework – ein Open-Source-Toolkit, das entwickelt wurde, um Operatoren effektiver, automatisierter und skalierbarer zu verwalten.
Das Operatoren-Framework  ist ein Open-Source-Toolkit, das aus mehreren low-level APIs besteht. Wir glauben, dass das neue Operatoren-Framework den nächsten grossen Schritt für Kubernetes darstellt, indem es eine Basis führender Praktiken verwendet, um die Barriere für die Anwendungsentwicklung auf Kubernetes zu verringern. Das Projekt bietet ein Software Development Kit (SDK) und die Möglichkeit, App-Installationen und -Aktualisierungen mithilfe des Lifecycle-Management-Mechanismus zu verwalten, während Administratoren die Operatoren-Funktionen in jedem Kubernetes-Cluster nutzen können.
Das Operatoren-Framework beinhaltet:

    • Operatoren-SDK: Ermöglicht es Entwicklern, Operatoren auf der Grundlage ihrer Fachkenntnisse zu erstellen, ohne dass Kenntnisse über die Komplexität der Kubernetes-API erforderlich sind.
    • Operatoren-Lifecycle-Management: Überwacht die Installation, Aktualisierung und Verwaltung des Lebenszyklus aller Operatoren (und der damit verbundenen Dienste), die über einen Kubernetes-Cluster laufen. Einmal gebaut, müssen die Operatoren auf einem Kubernetes-Cluster deployed werden. Der Operator-Lifecycle-Manager ist die Backplane, die die Verwaltung von Operatoren auf einem Kubernetes-Cluster erleichtert. Damit können Administratoren steuern, welche Operatoren in welchen Namespaces verfügbar sind und wer mit laufenden Operatoren interagieren kann. Sie können auch den gesamten Lebenszyklus der Operatoren und ihrer Ressourcen verwalten, z.B. Aktualisierungen für einen Operator und seine Ressourcen auslösen.
    • Operatoren-Metering (folgt in den kommenden Monaten): Ermöglicht Nutzungsberichte für Operatoren, die spezielle Dienste bereitstellen. In einer zukünftigen Version wird das Operatoren-Framework auch die Möglichkeit beinhalten, die Anwendungsnutzung zu messen – ein Kubernetes first, das Erweiterungen für zentrale IT-Teams zum Budgetieren und für Softwareanbieter, die kommerzielle Software anbieten, bietet. Operatoren-Metering wurde entwickelt, um in die CPU- und Speicherberichte des Clusters eingebunden zu werden, IaaS-Kosten zu berechnen und kundenspezifische Kennzahlen wie Lizenzierung zu berechnen.

Einfache, stateless Applikationen können die Lifecycle-Management-Funktionen des Operatoren-Frameworks nutzen ohne Code zu schreiben, indem sie einen generischen Operator (z.B. den Helm Operator) verwenden. Komplexe und stateful Applikationen sind jedoch der Ort, an dem ein Operator glänzen kann. Die cloud-ähnlichen Funktionen, die in den Operator-Code kodiert sind, können eine erweiterte Benutzererfahrung bieten und Funktionen wie Updates, Backups und Skalierung automatisieren.
Im nächsten Unterabschnitt diskutieren wir über das Operatoren-SDK, das in GitHub immer beliebter wird und im Allgemeinen über den „Operatoren-SDK Workflow“, der für die Generierung und Handhabung von Operatoren verwendet wird.
c) Popularität des Operatoren-SDK
Das Operatoren-SDK ist ein Toolkit, das kürzlich auf dem Operatoren-Framework aufgebaut wurde und die Werkzeuge zum Erstellen, Testen und Verpacken von Operatoren bereitstellt. Zunächst erleichterte das SDK die Verbindung der Businesslogik einer Anwendung (z.B. wie man skaliert, aktualisiert oder sichert) mit der Kubernetes-API, um diese Operationen auszuführen. Im Laufe der Zeit entwickelt sich das SDK jedoch weiter, so dass Entwickler Anwendungen intelligenter gestalten und die Benutzerfreundlichkeit von Cloud Services nutzen können. Infolgedessen sind führende Praktiken und Codemuster, die von allen Operatoren gemeinsam genutzt werden im SDK enthalten, um zu verhindern, dass das Rad neu erfunden wird.
Aus Entwicklersicht ist der Einstiegspunkt das Operatoren-SDK, das von CoreOS stammt und als Teil des Operatoren-Frameworks angeboten wird und nach seiner Selbstbeschreibung „ein Open-Source-Toolkit ist, um Kubernetes native Anwendungen, sogenannte Operatoren, effektiv, automatisiert und skalierbar zu verwalten“. Das SDK richtet sich spezifisch an Go-Entwickler und Applikationen und selbst wenn derzeit die Unterstützung für andere Programmiersprachen (z.B. Java, C, etc.) fehlt, gibt es bereits Zukunftspläne für deren Integration.
In GitHub wird das Operatoren-SDK zu einem sehr aktiven Projekt, das bereits eine hohe Sichtbarkeit/Popularität erlangt hat:

Selbst wenn das Projekt mit der Zeit immer beliebter wird, ist sein Projektstatus immer noch „pre-alpha“, was bedeutet, dass „signifikante Änderungen an der API in den kommenden Versionen erwartet werden„.
Daher erfordert das Operatoren-SDK Toolkit noch ein wenig mehr Reife, um in breiteren praktischen Arbeitsszenarien eingesetzt zu werden. Als Forscher glauben wir, dass dieses Software Development Kit (SDK) in Zukunft weit verbreitet sein wird, da es die Entwickler bei der Verwaltung von App-Installationen und -Updates mit Hilfe des Lifecycle-Management-Mechanismus unterstützen wird, während es Administratoren ermöglicht, die Operator-Fähigkeiten auf jedem Kubernetes-Cluster auszuüben (siehe folgende Abbildung, die die Gesamtansicht der geplanten Unterstützung des Operator-SDKs verdeutlicht).

Im Folgenden sprechen wir über den allgemeinen Workflow des Operatoren-SDK.
d) Allgemeiner Workflow von Operatoren-SDK
Das Operatoren-SDK  ist ein Toolkit, das die Werkzeuge zum Erstellen, Testen und Verpacken von Operatoren bereitstellt, wie in der folgenden Abbildung dargestellt.

Insbesondere stellt das Toolkit den folgenden spezifischen Workflow zur Verfügung, um das Schreiben, Erstellen, Testen und Paketieren eines neuen Go-Operators zu unterstützen:

      1. Erstelle ein neues Operatoren-Projekt mit Hilfe des SDK Command Line Interface (CLI)
      2. Definition neuer Ressourcen-APIs durch Hinzufügen von Custom Resource Definitions (CRD)
      3. Definition von Controllern zur Überwachung und Abstimmung von Ressourcen
      4. Schreibe die Abstimmlogik für deinen Controller mit dem SDK und der Controller-Laufzeit-APIs
      5. Verwende das SDK CLI um die Operatoren-Deployment-Manifeste zu erstellen und zu generieren

In diesem Zusammenhang verwendet das Operator-SDK für seinen Workflow die controller-runtime library, die das Schreiben von Operatoren erleichtert durch Bereitstellung von:

      • High level APIs und Abstraktionen, um die operationale Logik intuitiver zu schreiben.
      • Tools für Scaffolding und Codegenerierung, um ein neues Projekt zu bootstrappen.
      • Erweiterungen zur Abdeckung gängiger Anwendungsfälle von Operatoren.

Ein einfaches Beispiel für die Erstellung und Bereitstellung eines einfachen Operators mit dem SDK-Toolkit findest du im offiziellen Operatoren-SDK GitHub-Repository:
https://github.com/operator-framework/operator-sdk
Der daraus resultierende automatisch generierte GO-Operator stellt die folgende Referenzstruktur dar:

File/Folders
Purpose
cmd
Contains manager/main.go which is the main program of the operator. This instantiates a new manager which registers all custom resource definitions under pkg/apis/... and starts all controllers under pkg/controllers/... .
pkg/apis
Contains the directory tree that defines the APIs of the Custom Resource Definitions (CRD).
pkg/controller
This pkg contains the controller implementations.
build
Contains the Dockerfile and build scripts used to build the operator.
deploy
Contains various YAML manifests for registering CRDs, setting up RBAC, and deploying the operator as a Deployment.
[ Role-based access control (RBAC) is a method of regulating access to computer or network resources based on the roles of individual users within an enterprise ]
Gopkg.toml Gopkg.lock
The Go Dep manifests that describe the external dependencies of this operator.
vendor
The golang vendor folder that contains the local copies of the external dependencies that satisfy the imports of this project. Go Dep manages the vendor directly.

Im nächsten Blogbeitrag werden wir über den aktuellen Status des Operatoren-SDKs sprechen, z.B. verfügbare Versionen und Workflows.

Nächster Artikel

Abschnitt 2 – Unterstützte Operatoren-SDK Workflows

Zurück zur Übersicht

Zurück zur Übersicht Kubernetes Operatoren mit dem Operatoren SDK Framework entwickeln.

simon.beck

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Tech

Kubernetes Operatoren mit dem Operatoren SDK Framework entwickeln

Kubernetes Operatoren mit dem Operatoren SDK Framework entwickeln

Kubernetes hat sich zu einer omnipräsenten Plattform für das Hosting von Cloud-native Applikationen entwickelt. Als eher Low-Level-Plattform wird sie oft entwicklerfreundlich gemacht, indem sie in übergeordnete Plattformen wie OpenShift (OKD) verpackt und in eine Managed Service Plattform wie APPUiO umgewandelt wird, die in jede Cloud-Infrastruktur deployed werden kann. Applikationsentwickler interagieren mit Kubernetes hauptsächlich, indem sie geeignete Deployment-Deskriptoren erstellen und ihren Code, der die Deployments auslöst, forcieren. Aufgrund ständiger Funktionserweiterungen ist nicht so viel über nützliche Kombinationen von Annotationen auf Kubernetes-Deployments (und anderen deklarativ beschriebenen Objekten), Kubernetes-Operatoren (eine Art von Hooks) und Custom Resource Definitions bekannt
In dieser Beitragsserie teilen wir einige der Erfahrungen, die wir bei der Erforschung von Massnahmen zur Auslösung von Aktionen bei bestimmten Updates der Deskriptoren gesammelt haben, als Vorläufer dynamischer und autonomer Feedback-Loops, die die Deployments von Applikationen selbst verwalten können.
Insbesondere bieten wir Zugang zu den angepassten Originalbeispielen von Operatoren, die mit dem Operator SDK-Toolkit generiert wurden, die sich mit Kubernetes-Ressourcen befassen, indem sie Annotationen zu Kubernetes-Deployments und Kubernetes-Operator Konzepten kombinieren. Der Link zu unseren Operator Beispielen ist auf Github verfügbar: https://github.com/appuio/operator-sdk-examples. In weiteren Blog-Posts werden wir einige beschreiben und diskutieren, wie sie für eine fortgeschrittenere Entscheidungsfindung erweitert werden können. Insbesondere die Anpassung der (Go)-Operatoren, damit sie in verschiedenen Umgebungen funktionieren, erfordert die Änderung einiger wichtiger Go-Dateien (z.B. pkg/controller/memcached/memcached/memcached_controller.go wie in der folgenden Abbildung dargestellt).

IN WEITEREN BLOG-POSTS SPRECHEN WIR ÜBER

Abschnitt 1 – Kubernetes Operatoren, Operatoren-Framework und Operatoren-SDK
  • Hier diskutieren wir in einem allgemeinen Rahmen über Operatoren, Operatoren-Framework und Operatoren-SDK.
  • Dann werden wir über das Operatoren-SDK diskutieren, das in GitHub immer beliebter wird und im Allgemeinen über den „Operatoren-SDK Workflow“, der für die Generierung und Handhabung von Operatoren verwendet wird.
Abschnitt 2 – Unterstützte Kubernetes Operatoren-SDK Workflows
  • Hier werden die drei verfügbaren alternativen Workflows zur Generierung von Operatoren erläutert, die von den letzten Versionen der Operatoren-SDK APIs bereitgestellt werden.
  • Wir besprechen auch Vor- und Nachteile der Nutzung der verschiedenen Operatoren-Workflows.
Abschnitt 3 – Beispiele für unterstützte Kubernetes Operatoren-SDK Workflows
  • Hier zeigen wir Beispiele für die drei verfügbaren alternativen Workflows zur Generierung von Operatoren, die von den Operatoren-SDK APIs bereitgestellt werden.
  • Wir konzentrieren uns speziell auf Go-Operatoren, da sie unserer Meinung nach die stabileren verfügbaren APIs sind.
Abschnitt 4 – Beispiel(e) von Operatoren, die Dienste mit Prometheus monitoren (in Kürze verfügbar)
  • Hier zeigen wir ein Beispiel für einen Operator, der mit Prometheus (derzeit zur Überwachung von Kubernetes-Clustern eingesetzt) kommuniziert, um fortgeschrittenere Entscheidungen zu treffen (z.B. erweiterte Überwachung des Dienstes).

Über die Autoren

Diese Beitragsserie wurde von Dr. Josef Spillner und Dr. Sebastiano Panichella von der ZHAW (Zürcher Hochschule für Angewandte Wissenschaften) School of Engineering geschrieben. Vielen Dank an Josef und Sebastiano, dass sie ihr Wissen mit unseren Lesern teilen!

simon.beck

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Allgemein Tech

DevSecOps: Sicherheit für Entwicklung und IT-Betrieb

10. Dez. 2018

Was ist DevSecOps und sollte es mich interessieren?

DevSecOps (Development, Security, Operations, manchmal auch SecDevOps) schliesst den Themenkomplex Anwendungssicherheit in den DevOps-Prozess mit ein. Damit begegnet die agile Softwareentwicklung heutigen Herausforderungen der Cyber-Security. Durch Automatisieren und Schaffen einer Security-as-code-Kultur soll die Kollaboration zwischen Teams flexibel bleiben und die Sicherheit fortlaufend verbessert werden.

Was ist DevOps?

Bevor wir versuchen, den Begriff DevSecOps zu verstehen, müssen wir „DevOps“ verstehen. Was bedeutet dieser mittlerweile weit verbreitete Begriff? Er ist fast ähnlich vage wie die „Cloud“. Jedes moderne Business braucht sie beide, aber ist das etwas, was man einfach bestellen kann und geliefert bekommt? Wir verstehen unter DevOps die interdisziplinäre Zusammenarbeit zwischen Entwicklern (Developers) und Betreibern (Operators) von Software, was ermöglicht, Applikationen schnell und systematisch weiterzuentwickeln und bereitzustellen. Unser Verständnis von DevOps erklären wir im Detail unter „Was ist DevOps – was macht VSHN?“

Entstehung und Bedeutung von DevSecOps

Genau wie bei der traditionellen Trennung von Devs und Ops waren Security-Themen traditionell Aufgabe eines losgelösten Teams oder einzelner Personen. Sicherheitsbedenken wurden damit als outgesourced betrachtet und im Development eher hinten angestellt. Security als Silo, sozusagen. Security-Spezialisten sind gut darin, Sicherheitslücken zu entdecken, verstehen im traditionellen Umfeld aber nur selten, wie moderne Softwareentwicklungsteams – also eine agile DevOps-Organisation – zusammenarbeiten.
Um die Agilität und Reaktionsfähigkeit von DevOps voll ausschöpfen zu können und gleichzeitig der Anwendungssicherheit einen höheren Stellenwert zu geben, muss die Sicherheit integraler Bestandteil des Lebenszyklus sein und von Anfang an mit eingeplant werden.
Um die immer weiter zunehmende Bedeutung und Wichtigkeit der Cyber-Security zu unterstreichen, wurde deshalb der Begriff DevSecOps geformt.

DevSecOps bedeutet, dass alle, die am Softwareentwicklungsprozess beteiligt sind, mitverantwortlich für Sicherheit sind und diese fortlaufend gemeinsam verbessern, automatisieren und von Anfang an in den Entwicklungsprozess einbauen.

Security von Anfang an in DevOps-Workflows einbauen

Was wie eine Selbstverständlichkeit klingt, war (und ist) leider nicht immer so. Der klassische Entwickler macht sich mehr Gedanken über die Funktionalitäten als über die Sicherheit einer Applikation. Zusätzlich führen neue Technologien wie Container-Plattformen (bspw. Docker) und Microservices trotz der vielen Vorteile, wie der kontinuierlichen Bereitstellung von Code, auch zu neuen Problemen und Security-Bedenken, da immer kürzer werdende Releasezyklen manuell durchgeführten Tests nicht mehr standhalten können.
DevSecOps soll zu einem Umdenken führen, indem die IT-Sicherheit und Security-Features wo immer möglich in Automatisierungs-Workflows mit eingebunden werden. Die Integration bestehender Sicherheits-Teams und Mitarbeiter und eine damit einhergehende kulturelle Änderung ist hierbei ebenso wichtig wie die Auswahl der richtigen Security-Tools.
Beim DevSecOps-Ansatz soll die Sicherheit von Anfang an mit eingebaut sein und nicht nachträglich hinzugefügt oder erst nach Abschluss der Entwicklung angedacht werden. Sowohl Entwicklung, IT-Betrieb und Sicherheits-Teams müssen bezüglich Informationssicherheit sensibilisiert werden und am gleichen Strang ziehen. Transparenz, kontinuierliches Feedback und gegenseitige Einblicke sind genauso wichtig wie das Teilen bekannter Bedrohungen und Sicherheitslücken. Für Entwickler erfordert dies oft ein Umdenken, da diese Prozesse nicht immer Bestandteil der Anwendungsentwicklung waren.

DevSecOps Automatisierung = Automatisierung der Sicherheit

Eine erfolgreiche Anwendung des DevSecOps-Prinzips setzt die Automatisierung von sich wiederholenden Aufgaben und Checks voraus, da manuelle Sicherheitsprüfungen zum einen viel Zeit beanspruchen, zum anderen auch fehleranfälliger sind.
Technologien, die DevSecOps erleichtern, sind Container und Microservices: DevOps-Sicherheitspraktiken müssen angepasst werden, da diese nicht für statische oder manuelle Tests geeignet sind. Die Informationssicherheit muss im gesamten Applikationszyklus integriert sein und kontinuierlich verbessert werden. Moderne agile Teams nutzen bereits automatisierte Validierungs- und Testpunkte innerhalb der DevOps-Pipelines, um die Sicherheit von Applikation und Code zu erhöhen und gleichzeitig schnelle Releasezyklen zu ermöglichen. Wenn die Tests und Checks nicht in die CI/CD-Pipelines integriert werden können, wird der Entwicklungsprozess die Sicherheitsprüfung voraussichtlich umgehen, was wiederum zu Sicherheitslücken führen kann.
DevSecOps macht die Sicherheit also zum festen Bestandteil im gesamten Prozess der Entwicklung. DevOps-Teams müssen die Sicherheit von Anfang an stufenweise einbauen und so gut es geht automatisieren, um sämtliche Daten, Microservices, Container und CI/CD-Prozesse kontinuierlich testen und schützen zu können. Integriertes Testing sollte dabei in Echtzeit dem Team einen Überblick geben können und Sicherheitslücken und Bugs schnell erkannt und geschlossen werden.

Fazit: Sicherheit ist heute wichtiger denn je

Fast tägliche Meldungen über Cyberangriffe, Sicherheitslücken, Datenverluste und lasche Security-Standards grosser Konzerne rufen uns immer wieder in Erinnerung, wie wichtig Security heute ist. Security sollte auch in DevOps-Teams zum Standardrepertoire gehören und mit heutigen Ansätzen und Tools ist der Zusatzaufwand meist überschaubar.
Durch die kurzen Entwicklungszyklen heute ist es möglich, früher zu testen und damit Probleme früher zu erkennen. Die Integration von Anwendungssicherheit bedeutet demnach auch, Security- und Testing-Tools bereits im Entwicklungsprozess einzusetzen und nicht erst im Live-Betrieb der Applikation.

Lohnt sich DevSecOps?

Natürlich bedeutet die Integration von Security in den DevOps-Prozess mehr Aufwand (als es nicht zu machen), langfristig lohnt sich dieses Investment aber. Agilität und Sicherheit lassen sich nicht nur verbinden, sie profitieren sogar voneinander, wenn das Team Transparenz, Offenheit und das Weitergeben von Know-How lebt. Und spätestens mit den Negativschlagzeilen aus der jüngeren Vergangenheit sollte jedem klar sein, dass wer bei Security spart, immer am falschen Ende spart.

SIGS DevSecOps Forum

Aarno, unser CTO, hat am SIGS DevSecOps Forum vom Di. 04.12.2018 bei der Mobiliar (Bern) einen Talk zum Thema Continuous (Security) improvement in the DevOps process gehalten.

Die Slides zu Aarnos Vortrag findest du hier:

Continuous security improvements in the DevOps process from Aarno Aukia

Weiterführende Links

In der agilen Softwareentwicklung gibt es auch den Begriff „nach links verschieben“ („shift left“), was soviel bedeutet wie, die Validierung in frühere Phasen der Entwicklung zu verschieben (siehe auch DevSecOps.org).
Oder Security wird als Customer Feature behandelt anstatt nicht-funktionale Requirements in das Product Backlog hinzuzufügen (Michele Chubirka aka „Mrs. Y“ auf postmodernsecurity.com).

Wie stehst du zu DevSecOps?

Was bedeutet das Thema DevSecOps für dich? Ist es für dich bereits der neue Standard oder nur eine weitere Etappe auf dem Weg zu GitOps? Über dein Feedback zum Thema würden wir uns sehr freuen, über @vshn_ch, per Mail oder das Kontaktformular unten.

Markus Speth

Marketing, Communications, People

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Event Tech

Open Source Monitoring Conference 2018

14. Nov. 2018

Unser Marco Fretz hat die OSMC (Open Source Monitoring Conference) 2018 in Nürnberg besucht und berichtet nachfolgend von seinen Eindrücken.

Die OSMC 2018

Bei der viertägigen OSMC mit rund 300 Besuchern dreht sich alles um Monitoring Tools, Konzepte und die Automatisierung des Monitoring Systems. Natürlich ist Icinga2 sehr stark vertreten – in den Talks, unter den Teilnehmern und Organisatoren. Die Konferenz wird von NETWAYS, der Firma hinter Icinga2, organisiert und findet jährlich im Holiday Inn Hotel in Nürnberg statt.
Am ersten Tag fanden Workshops zu verschiedenen Themen und am vierten Tag ein Hackathon statt, mit Projekten, welche spontan bestimmt wurden. Die englischen und deutschen Talks fanden am zweiten und dritten Tag statt und waren in drei Tracks aufgeteilt. Dank der Agenda (online, vor den Räumen und hinten auf dem Badge) konnte man sich meistens recht leicht für den spannendsten Track entscheiden. Talks, die man verpasst hat, findet man natürlich später online als Video.
Ich habe wieder nur Tag zwei und drei besucht (die Talks). Mit ca. EUR 1500.- für zwei Tage Konferenz, drei Abend-Events und drei Übernachtungen im selben Hotel ist die Konferenz auch preislich sehr attraktiv.
Bekannt ist die OSMC auf jeden Fall auch für das reichhaltige und ausgezeichnete Catering (all-you-can-eat) vom Frühstück bis zu den Abend-Events und den reibungslosen Ablauf – der Hotel und Konferenz Check-In sind in unter einer Minute abgeschlossen. Das hat sich auch dieser Jahr wieder bewahrheitet.
Weitere Eindrücke: #OSMC

Highlights

Für mich war das Wichtigste, neue und bekannte Gesichter zu treffen und der damit verbundene Austausch über die eigene und andere Monitoring Landschaften inkl. deren Probleme und Lösungsansätze sowie natürlich auch der direkte Draht zu NETWAYS / Icinga. Dank dem Talk von @ekeih (scaling Icinga2 …) fanden sich schnell einige Leute, die Icinga2 in einem ähnlichen Setup bzw. Grösse wie wir betreiben.

Prometheus

Spannende Talks zu Prometheus bzw. Konzepten, die auf Prometheus setzen gaben zu spüren, dass Prometheus immer mehr Verbreitung findet, nicht nur in der „Cloud-native“ Welt sondern z.B. auch für HTTP SLA Monitoring (MORITZ TANZER, nic.at), Netzwerk Monitoring (MATTHIAS GALLINGER, ConSol), etc.
Unsere aktuellen Pläne bei VSHN für die Integration von Prometheus in unsere Monitoring Umgebung fanden somit auch hier Bestätigung.

IcingaDB

Ein grosser Flaschenhals bei Icinga2 und Icingaweb2 ist die IDO Datenbank (MySQL / Postgres), dessen Schema noch aus der Nagios und Icinga1 Ära stammt und im Laufe der Zeit ständig verschlimmbessert wurde. Damals schien eine relationale Datenbank für eigentlich volatile Status Informationen wie Service und Host States, etc. Sinn zu machen. In grösseren Setups sind nun aber die Writes von Icinga2 in die DB das bottleneck. Auch leidet die Query Performance von Icingaweb2 in gewissen Konfiguration bei grösseren Setups stark.


Sehr viele Details sind noch nicht bekannt, jedoch kommt Redis für die volatile Status Informationen und eine SQL DB für die historischen Daten zum Einsatz. Eine erste Version läuft bei Icinga bereits testweise und wurde in einer Live Demo vorgestellt. Schön finde ich, dass man wohl das IDO DB und das IcingaDB Modul parallel verwenden kann (übergangsweise), gleiches gilt für das Icingaweb2 Monitoring Modul – Das wird eine Migration stark vereinfachen.
https://twitter.com/jensschanz/status/1059838540748599296

Zum mitnehmen

Einfach auszuprobieren…

OpenAPM

OpenAPM ist kein Tool an sich sondern zeigt auf einfach Weise, welche Tools sich wie miteinander kombinieren lassen, um eine Application Performance Management / Monitoring Landschaft aufzubauen. Einfach hier ausprobieren: https://openapm.io/landscape

Maps

Sicher auch spannend sind die Maps für Icinga2. Man kann jedem Host oder Service Object die Geolocation via custom variable mitgeben, dann werden diese automatisch auf der Map angezeigt und je nach Zoom-Faktor gruppiert: https://github.com/nbuchwitz/icingaweb2-module-map

Rancher Monitoring

Aus dem Talk von @ClaudioKuenzler ein Plugin zum einfachen Überwachen von Rancher2 und Kubernetes: https://github.com/Napsty/check_rancher2

Fazit

Tolle Ideen mitgenommen, neue Leute kennengelernt, viel gegessen (ja der Gin war auch gut (big grin)). Eine super Konferenz, die sich lohnt. Ich geh gerne wieder.

Marco Fretz

Marco ist einer der General Manager von VSHN und Chief Operating Officer.

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Allgemein Tech

Beschleunige und vereinfache Applikations-Releases durch Migration in die Cloud

27. Sep. 2018

Egal in welchem technischen Bereich der Softwareentwicklung du tätig bist, vermutlich musst du die Applikationen, die ihr aktuell entwickelt, möglichst schnell auf den Markt bringen.

Eure Kunden können nicht ewig warten – die Softwareentwicklung muss beschleunigt werden.

Zeit ist Geld und ein überaus kostbares Gut, insbesondere wenn ihr kurz vor der Markteinführung eurer neuesten Killerapplikation steht. Eure Kunden können nicht ewig warten und du musst deine Applikationen so schnell wie möglich auf den Markt bringen, wenn du in der schnelllebigen Techwelt bestehen möchtest.
Vielleicht wirst du auch intern dazu gedrängt, den Time-to-Market so kurz wie möglich zu halten.
Du kannst nicht erst interne Ressourcen aufbauen, Kollegen schulen und Erkenntnisse sammeln. Du musst den Konkurrenten immer einen Schritt voraus sein. IT-Teams müssen heutzutage immer mehr leisten, deshalb müssen sie intelligent geführt werden.

Häufige Probleme bei der Einführung von Applikationen

Der Weg bis zum Release einer Applikation kann steinig sein und viele Irrwege oder sogar Sackgassen aufweisen. Deshalb ist es so wichtig, jede kleine Optimierung oder Änderung in einer oder mehreren Testumgebungen zu prüfen, bevor sie in der für den Endnutzer sichtbaren Produktionsumgebung implementiert werden. Je früher ein Bug in der App oder in der Umgebung gefunden wird, desto schneller und einfacher kann er behoben werden.
Zu den teuersten und zeitaufwändigsten Fehlern zählen Abweichungen zwischen Test- und Produktionsumgebungen. Diese führen dazu, dass sich die Applikation während des Testings korrekt verhält, aber in der Produktionsumgebung plötzlich Fehler auftauchen, obwohl die gleiche Applikationsversion implementiert wurde und du weisst nicht, welche Änderungen zu den Problemen geführt haben. Die Folgen reichen von Fehlermeldungen bis hin zu katastrophalen Ausfällen in öffentlich zugänglichen Applikationen und das Resultat kann in einem langfristigen Imageschaden für dein Unternehmen enden.
Ein weiteres sicherheitsbezogenes Problem besteht darin, Test- und Produktionsumgebungen voneinander zu trennen, um zu verhindern, dass fehlerhafte Applikationen in der Testumgebung echte Kundendaten beschädigen.
Anstatt Dev-, Test- und Produktionsumgebungen manuell zu synchronisieren und diesen Aufwand in jedem Prozessschritt zu wiederholen, kann diese Arbeit auch mithilfe von bewährten cloud-basierten Tools automatisiert werden.

Warum solltest du Applikationen in die Cloud migrieren?

Möglicherweise zögerst du noch aus verschiedenen Gründen, eure Applikationen in die Cloud zu migrieren. Vielleicht bist du an die klassische Vorgehensweise zum Entwickeln und Testen von Applikationen gewöhnt. Vielleicht scheust du auch mühsame Migrationsprozesse oder ihr verfügt einfach nicht über das nötige interne Know-how oder die Ressourcen, um eine Cloud-Migration zu stemmen.
Allerdings kann ein gut vorbereitetes DevOps-Team, welches das Potenzial der Cloud voll ausschöpft, das Deployment von Applikationen rasant beschleunigen, ohne signifikante Erhöhung des Personals oder der langfristigen Kosten. Dadurch kann es deutlich einfacher werden, die Applikation später zu skalieren und es können zusätzlich nützliche Hilfsdienste genutzt werden.
Indem du unterschiedliche Umgebungen mittels der Open Source Software Docker vereinheitlichst, kannst du das weltweite Ökosystem und den globalen Erfahrungsschatz der Community nutzen. Je mehr Teile des Prozesses du automatisieren und integrieren kannst, desto effizienter kannst du deine Anwendung entwickeln und auf den Markt bringen.

White Paper „5 Schritte für eine erfolgreiche Migration von Applikationen in die Cloud”

Zusammengefasst ist die Migration in die Cloud eine sehr weitreichende Geschäftsentscheidung, deshalb solltest du dich zuvor ausführlich informieren. Lade unser White Paper „5 Schritte für eine erfolgreiche Migration von Applikationen in die Cloud” herunter um zu erfahren, wie du die Cloud für deine Software- und Applikationsentwicklungsziele nutzen und wie ihr als Team und euer Unternehmen als Ganzes davon profitieren könnt.

Markus Speth

Marketing, Communications, People

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Interne Tech

Wir haben Geburtstag!

16. Sep. 2018

Aarno Aukia

Aarno ist Mitgründer der VSHN AG und als CTO für die technische Begeisterung zuständig.

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Allgemein Tech

Vorteile von Docker und Containertechnologien für dein DevOps-Team

15. Sep. 2018

DevOps erfordert drei Dinge: Menschen mit der richtigen Einstellung, gemeinsame Prozesse und die richtigen Tools. Docker Software Container tragen dazu bei, diese Herausforderungen zu lösen und bieten eine standardisierte Plattform für die Entwicklung und den Betrieb von Applikationen.

Container aus der Sicht des Entwicklers

Aus der Perspektive einer Webagentur stellt jedes Projekt andere Anforderungen an das Zielsystem, wie z. B. unterschiedliche Versionen von Programmiersprachen und Frameworks. Diese Kombinationen müssen in der Entwicklungsphase mittels Continuous Integration (CI) eingehend getestet werden, was bei traditionellen Systemen zeitaufwändig und fehleranfällig ist.
Eine Virtualisierung mittels Containern, wie z. B. mit Docker, schafft da Abhilfe. Docker verwendet sogenannte „Images”, also Software-Zusammenstellungen, um einzelne Instanzen einer App zu starten – sogenannte Container. Anders als traditionelle virtuelle Maschinen umfassen diese Images kein Betriebssystem und sind deshalb kleiner und schneller. Ideal für Continuous Integration.
Aus Sicht des Softwareentwicklers ist es einfach, die Pipelines mit Docker, beispielsweise innerhalb von GitLab CI, zu konfigurieren. Man muss nur das Image spezifizieren und der Runner kümmert sich um alles Weitere. Die Applikation wird somit enkapsuliert getestet und erfordert keine weitere Software auf dem Server.
Docker nutzt Ressourcen effizienter als traditionelle Systeme im CI-Umfeld und bietet eine echte Zeitersparnis dank einfacherer Konfiguration.

Container aus der Sicht des Betreibers

Docker-Container sind eine standardisierte und effiziente Möglichkeit, Software mit allen zusätzlich erforderlichen Tools zu bündeln. Dies trägt zum Einen dazu bei, externe Abhängigkeiten zur Laufzeit zu verringern, sodass die richtigen, zu verwendenden Versionen von PHP, Java usw. mit allen erforderlichen Modulen, Erweiterungen und Plugins nicht separat auf dem Server verwaltet werden müssen.
Zum Anderen ist die Änderung des Applikationscodes und eine Änderung des Applikationsservers nun identisch: Eine neue Version eines Container-Images wird automatisch erstellt und in der Testumgebung deployed und anschliessend kann das geprüfte Image auch in der Produktionsumgebung ausgerollt werden.

Die Vorteile der Standardisierung von Software-Containern ähneln den Vorteilen von Containern in der Logistikbranche.

  • Container standardisieren die Handhabung von Inhalten: In der Logistikbranche verfügen alle Container über die gleichen Aufnahmepunkte in den Ecken – egal, ob der Inhalt des Containers flüssig, fest oder gasförmig ist. In der Software sind Entrypoint, Listenport und Storage-Volumes exakt gleich definiert, ungeachtet davon, ob PHP, Java oder .NET Core ausgeführt werden soll.
  • Die Containertechnologie ist portabel, so dass sie ebenso wie andere Transportmittel in allen Infrastrukturen und bei allen Anbietern gleich funktioniert.
  • Dank Standardisierung sind Container effizienter: So wie ein Containerschiff mit der gleichen Mannschaft 21.000 verschiedene Container transportieren kann, so kann ein PaaS-Anbieter hunderttausende Container in unterschiedlichen Kundeninfrastrukturen und bei verschiedenen Cloud-Anbietern betreiben.

Deshalb wird die Lösung in der Software-Logistik als Container-Orchestrierung bezeichnet, deren bekannteste Umsetzung Kubernetes ist. Sie standardisiert und automatisiert Software-Betriebsprozesse wie Deployment/Update, Skalierung, Load-Balancing, Service-Discovery, Storage-Volume-Management oder Monitoring, Backup, Verteilung von Containern auf mehrere Server sowie die Isolation von mehreren Applikationen, Testumgebungen, Teams und/oder Kunden.

Was bedeutet das für dich – solltest du deine Applikation containerisieren?

Möglicherweise gibt es viele Gründe, warum du noch nicht auf Docker oder Containertechnologien im Allgemeinen setzt. Vielleicht bist du an die klassische Vorgehensweise zum Entwickeln und Testen von Applikationen mittels traditioneller VM-Technologie gewöhnt. Vielleicht scheust du auch mühsame Migrationsprozesse oder ihr verfügt nicht über das nötige interne Know-how oder Ressourcen. Oder du hast eine Legacy-Applikation, die sich nicht so einfach in die Cloud übertragen oder migrieren lässt.
Solltest du also auf diesen Zug aufspringen – oder um bei der gleichen Metapher zu bleiben – auf dieses Schiff steigen?
Ein gut vorbereitetes DevOps-Team, welches das Potenzial der Containertechnologie voll ausschöpft, kann die schnelle Bereitstellung (Deployment?) von Applikationen ohne signifikante Erhöhung von Personal oder Kosten stemmen. Mithilfe von Containertechnologien wie Docker, Kubernetes oder OpenShift ist es sehr viel einfacher, deine Applikation in die Cloud zu migrieren.
Darüber hinaus wird das spätere Skalieren der Applikation sehr viel einfacher, Zugriff auf nützliche Hilfsdienste wird ermöglicht und die Applikation insgesamt einfach zukunftssicherer. Wenn du also bisher mit einer Legacy-Applikation gearbeitet hast, lohnt es sich wahrscheinlich für die Zukunft, jetzt die Zeit und Ressourcen zu investieren, um die Applikation bereit für Containertechnologien zu machen.
Indem unterschiedliche Umgebungen mittels der Open Source Software Docker vereinheitlicht werden, kann das weltweite Ökosystem und der globalen Erfahrungsschatz der Community genutzt werden. Je mehr Teile des Prozesses automatisiert und integriert werden, desto effizienter kannst du deine Applikation entwickeln und auf den Markt bringen. Deine Kunden und Teamkollegen werden es dir danken.

White Paper „5 Schritte für eine erfolgreiche Migration von Applikationen in die Cloud”

Wenn du mehr über die Migration deiner Applikation in die Cloud erfahren möchtest, lade unser kostenloses White Paper „5 Schritte für eine erfolgreiche Migration von Applikationen in die Cloud” herunter und finde heraus, wie du die Cloud für deine Software- und Applikationsentwicklungsziele nutzen kannst.

White Paper herunterladen

Markus Speth

Marketing, Communications, People

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Kubernetes Tech

Was ist eine Kubernetes Distribution und was sind die Unterschiede zwischen Kubernetes und OpenShift?

30. Aug. 2018

Update: hier findest du unsere Kubernetes Distributionen 2026 Übersicht.

Bei VSHN und APPUiO.ch setzen wir auf OpenShift als Kubernetes Distribution. Was eine Kubernetes Distribution ist, warum wir das machen und wo die Unterschiede zu „plain“ Kubernetes liegen erklären wir in diesem Blogpost.

Was ist Kubernetes?

Die offizielle Beschreibung von Kubernetes lautet:

Kubernetes is a portable, extensible open-source platform for managing containerized workloads and services, that facilitates both declarative configuration and automation.

Der wichtigste Teil daraus ist die Tatsache, dass es sich um eine Plattform handelt und nicht um ein fertiges Produkt ab der Stange. Für das Verständnis dieses Beitrags ist dies eine wichtige Information.

Was ist eine Kubernetes Distribution?

Um die Unterschiede von Kubernetes und OpenShift zu verstehen, gilt es zuerst einmal den Begriff „Kubernetes Distribution“ zu klären: Wird Kubernetes direkt aus dem Open Source Kubernetes Projekt installiert, erhält man „nur“ die Kernkomponenten (API Server, Controller Manager, Scheduler, Kubelet, kube-proxy). Damit Kubernetes aber auch wirklich benutzbar wird, benötigt man sehr viele weitere Komponenten wie etcd, Ingress Controller, Logging Server, Metrics Collector (z.B. Prometheus), Software Defined Network (SDN) und viele mehr. Dies ist sehr gut vergleichbar mit Linux: Der Linux Kernel alleine bringt noch nicht viel, es braucht eine ganze Linux Distribution welche eine Shell, das Paketmanagement, den Bootprozess und vieles mehr zur Verfügung stellt.

OpenShift ist eine Kubernetes Distribution und macht aus Kubernetes ein Produkt

Eine „Minimum Viable Kubernetes Distribution“ benötigt folgende zusätzlichen Komponenten und Tools für einen produktiven Betrieb:

  • Installations- und Upgrademechanismus: Für eine automatisierte Installation aller involvierten Komponenten.
  • SDN (Software Defined Network): Pods müssen untereinander kommunizieren können, egal wo sie laufen. Dies stellt das SDN sicher.
  • Ingress Controller: Damit Benutzerzugriff auf die auf dem Cluster laufende Applikationen möglich ist.
  • Authentication: Eine zentrale Benutzer- und Gruppendatenbank stellt den authentisierten und autorisierten Zugriff zur Verfügung.
  • Security: Kubernetes führt Container via Docker oder CRI-O aus. Die Sicherheit auf dem Hostsystem muss entsprechend gewährleistet sein.
  • Persistent Storage: Stateful Applikationen wie Datenbanken benötigen persistenten Storage.
  • Monitoring: Ständige Überwachung aller Clusterkomponenten und Applikationen.
  • Backup: Sicherung der Clusterkomponenten und Persistenten Daten.

Optional werden weitere Komponenten empfohlen:

  • Zentrales Logging mit grafischer Aufbereitung und Durchsuchbarkeit
  • Applikations- und Cluster Metrics inkl. Alerting

OpenShift als Kubernetes Distribution

Im Kern basiert OpenShift zu 100% auf Kubernetes, bringt aber als Kubernetes Distribution alles mit, was zur Benutzung eines Kubernetes Clusters benötigt wird. Um nur die wichtigsten Funktionen zu nennen:

  • Operations Tools: Ein offizieller und unterstützter Weg via Ansible ermöglicht den gesamten Lifecycle von OpenShift durchzuführen. Dazu gehört die automatisierte Installation, wie auch Upgrades auf neuere Versionen von OpenShift.
  • Router: Der OpenShift Router (Ingress Controller) – basierend auf HAProxy – sorgt dafür, dass der Zugriff auf Applikationen innerhalb des Clusters über HTTP(S) ermöglicht wird.
  • Multi-Tenancy: Die im Kern eingebaute Multi-Tenancy über OpenShift Projekte, RBAC und weitere Konzepte ermöglicht die Benutzung der Plattform durch verschiedene Stakeholder.
  • Authentication: Es werden die unterschiedlichsten Authentication Backends unterstützt, allen voran LDAP, ActiveDirectory und weitere.
  • Metrics: Die mitgelieferte Metrics Komponente sammelt alle verfügbaren Messwerte (RAM, CPU, Netzwerk) der auf dem Cluster laufenden Applikationen und visualisiert diese in der Webkonsole.
  • Central Logging: Alle von der Applikation auf stdout geloggten Zeilen werden automatisch von der zentralen Logging Komponente gesammelt und über die Webkonsole dem Benutzer zur Verfügung gestellt.
  • Security: Die Plattform ist auf höchste Sicherheit ausgelegt. So sorgen z.B. Sicherheitsmassnahmen im Kernel von Red Hat Enterprise Linux wie SELinux dafür, dass die Sicherheit der Container gewährleistet ist. Weitere Massnahmen wie „Security Context Constraints“ (SCC) und das Verhindern von Root Containern sorgen für weitere Sicherheit.
  • Builds und Pipelines: Direkt im Cluster integrierte Build- und Pipeline-Funktionalitäten ermöglichen einen komplett integrierten CI/CD Workflow.
  • Webkonsole: Alle Vorgänge auf dem Cluster werden für den Anwender der Plattform in einer Webkonsole graphisch dargestellt und ermöglichen einen einfachen und schnellen Einstieg in die Benutzung von Kubernetes.
  • SDN: Das mitgelieferte Software Defined Networking sorgt für die Konnektivität zwischen den auf der Plattform laufenden Pods und für eine angemessene Netzwerksicherheit mit Network Policies.
  • Container Registry: Docker / Container Images werden in der mitgelieferten Registry gespeichert und zum Deployment auf die Worker Nodes benutzt.

Alle diese von Haus aus mitgelieferten Funktionalitäten lassen sich zu jedem Kubernetes Cluster hinzufügen, was jedoch mit einem hohem Aufwand verbunden ist. Vergleichbar mit dem Bau einer eigenen Linux Distribution, wie das z.B. Linux From Scratch veranschaulicht. Für Kubernetes existiert eine ähnliche Anleitung, genannt Kubernetes The Hard Way.

OpenShift als PaaS

Die Stärke von Kubernetes liegt in der Container Orchestrierung. Zusätzlich dazu bietet OpenShift klassische Platform-as-a-Service (PaaS) Funktionen. Eine davon ist das automatische builden und deployen von Applikationscode direkt ab einem Git Repository. Trotzdem hat man als Anwender der Plattform dank der grossen Flexibilität aber immer die Wahl, ob man die integrierten Buildfunktionen nutzen möchte, oder doch lieber ausserhalb des Cluster builden möchte. Dies lässt sich für jedes Deployment entscheiden, so können auf einem Cluster beide Arten verwendet werden.

OpenShift als Upstream zu Kubernetes

Viele Entwicklungen in Kubernetes stammen ursprünglich aus OpenShift. Als bestes Beispiel lässt sich RBAC (Role Based Access Control) nennen. Dieses Feature ist seit der ersten OpenShift-Version Bestandteil und wurde sukzessive in Kubernetes eingebaut. RBAC ist seit Kubernetes Version 1.6 fester Bestandteil von Kubernetes. Auch das OpenShift „Route“- oder das „DeploymentConfiguration“-Objekt hat die heutigen Objekte „Ingress“ bzw. „Deployment“ in Kubernetes massgeblich mitgeprägt.
Da OpenShift zu 100% auf Kubernetes basiert, werden auch alle Kubernetes Native Workloads unterstützt, wie z.B. das „Deployment“- oder das „Ingress“-Objekt.
Schaut man etwas genauer auf die Contributor-Statistiken stellt man fest, dass Red Hat zu den Top 3 Contributor-Firmen gehört, somit ist Red Hat massgeblich an der Entwicklung von Kubernetes beteiligt. Mit dem Kauf der Firma CoreOS hat sich Red Hat geballtes Kubernetes Know-how angeeignet. Die Verschmelzung von OpenShift und Tectonic wird der nächste Meilenstein der Kubernetes Distribution OpenShift sein.

Alternativen zu OpenShift

OpenShift ist nicht die einzige Kubernetes Distribution auf dem Markt. Ein kurzer Vergleich zeigt die Unterschiede:

  • Cloud Vendor Kubernetes: Die grossen Clouds bieten ihre eigenen Kubernetes Distributionen als Service an. Diese sind auf die jeweiligen Clouds zugeschnitten und werden von den Anbietern gepflegt. Eine Installation auf der eigenen Private Cloud oder auf anderen Public Clouds ist nicht möglich.
  • Rancher: Seit der Version 2.0 fokussiert sich Rancher zu 100% auf Kubernetes und bietet als grosse Stärke eine Multi-Cluster Verwaltungsfunktion. So können mit Rancher Kubernetes Cluster in der Cloud (z.B. auf Amazon oder Google) zentral verwaltet werden, wie auch Kubernetes Cluster mit der „Rancher Kubernetes Engine“ auf eigenen VMs. Mit dem Webinterface gestaltet sich das aufsetzen eines neuen Clusters sehr einfach und Applikationsdeployments mittels Helm sind auch direkt verfügbar.
  • Tectonic: Diese Distribution legt grossen Wert auf Cloud-Native-Automatisierung. Durch den Kauf von CoreOS durch Red Hat wird Tectonic mit OpenShift zusammengeführt und viele der Funktionen werden von Tectonic in OpenShift eingebracht.
  • Canonical / Ubuntu Kubernetes: Plattform basierend auf Ubuntu, welches Juju als Installationstool verwendet. In Partnerschaft mit Google und Rancher wird in Zukunft eine Hybrid-Cloud-Lösung angeboten.
  • SUSE CaaS-Plattform: Eine sehr neue Plattform, basierend auf SUSE MicroOS. Mittels Salt wird die Konfigurationsverwaltung sichergestellt. Unter folgendem Link kann am Beta Programm teilgenommen werden: SUSE CaaS Platform Beta.

Weitere Kubernetes Distributionen aufgelistet:

Ein sehr wichtiger zu beachtender Aspekt ist der Cloud- und/oder Vendor-Lock-In. Viele der Kubernetes Distributionen haben ihre eigenen Eigenschaften, die unter Umständen nicht miteinander kompatibel sind. Am Beispiel der „Cloud-Vendor“-Distributionen: Diese können nur in der entsprechenden Cloud benutzt werden. Möchte man jedoch einen Hybrid-Cloud-Ansatz verfolgen, ist dies durch den Lock-In nicht möglich. Im Gegenzug ermöglicht eine selber installierbare Distribution wie OpenShift diese Option.
Reine Open Source Distributionen ohne Herstellersupport sind für produktive Umgebungen nicht zu empfehlen, da dieser für eine komplexe Plattform wie Kubernetes von grossem Vorteil ist.

APPUiO – Swiss Container Platform

Dem aufmerksamen Leser ist bestimmt aufgefallen, dass zwischen der „Minimum Viable Kubernetes Distribution“ und OpenShift gewisse Diskrepanzen bestehen. Genau dort setzt APPUiO an: Wir veredeln OpenShift zu einer vollständigen, production-ready Kubernetes Distribution indem wir Managed Services anbieten. Wir überwachen und sichern den Clusterstatus automatisch, kümmern uns um regelmässige Updates, beheben Fehler, stellen Persistent Storage zur Verfügung und helfen mit unserem Know-how das Beste aus der Plattform herauszuholen.

Weitere Informationen zum Thema Kubernetes und OpenShift

Am Cloud Native Meetup vom 28. August 2018 haben wir über das Thema Kubernetes Distribution berichtet, die Slides dazu sind auf Speaker Deck zu finden. Mehr zum Thema OpenShift, Docker und Kubernetes findest du ausserdem hier. Ein weiterer empfehlenswerter Blogpost zu diesem Thema von Tomasz Cholewa: 10 most important differences between OpenShift and Kubernetes (englisch, technisch).

Wie können wir helfen?

Durch unsere Erfahrung im Betrieb von OpenShift Clustern rund um die Welt bieten wir Managed OpenShift Cluster auf nahezu jeder Public, Private oder On-Premise Cloud an. Oder besteht Interesse an einer anderen Kubernetes Distribution als OpenShift? Wir helfen gerne bei der Evaluation, Integration und Betrieb und unterstützen mit unserer langjährigen Kubernetes Erfahrung.
Kontaktiere uns, folge uns auf Twitter oder wirf einen Blick auf unsere Services.
Wir freuen uns auf dein Feedback!

Tobias Brunner

Tobias Brunner arbeitet seit über 20 Jahren in der Informatik und seit bald 15 Jahren im Internet Umfeld. Neue Technologien wollen ausprobiert und darüber berichtet werden.

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Tech

Docker Overlay Verschlüsselung

24. Aug. 2018

Docker Swarm mit verschlüsseltem Node-to-Node Traffic

VSHNeer Elia hat einen Docker Swarm Cluster mit vollständiger Trafficverschlüsselung innerhalb des Clusters eingerichtet (Crosspost zu seinem privaten Blog):

Ich habe einen Docker Swarm Cluster in der neuen Hetzner Cloud eingerichtet. Das Wichtigste zuerst – die Hetzner Cloud ist wirklich grossartig: Super einfach, super günstig und funktioniert wie erwartet. Es ist kein aufgeblähter Cloud-Anbieter, der über 100 Dienste und Funktionen verfügt, die du für deine Server nutzen kannst. Das hält die Kosten und die Komplexität niedrig – ich bin wirklich ein grosser Fan davon.

Zum eigentlichen Thema: Da das Feature-Set einfach gehalten ist, bietet die Hetzner Cloud (vorerst) kein privates Netzwerk. Bei nur öffentlichen IP-Adressen müssen wir den Overlay-Traffic zwischen unseren Docker-Containern sichern!

Das Problem

Standardmässig verschlüsselt Docker Swarm den Datenverkehr zwischen den Managern, so dass wir dort keine Probleme haben. Diese Standardeinstellung ist jedoch nicht für den Container-zu-Container-Verkehr festgelegt. Jeglicher Datenverkehr, der das Overlay-Netzwerk verwendet, ist standardmässig nicht verschlüsselt, da die meisten Nutzer private Netzwerk-Setups mit einer Floating-IP als Zugriffspunkt auf den Cluster nutzen. Docker geht davon aus, dass das private Netzwerk sicher ist und schont daher einige Ressourcen für andere Aufgaben (was bei DigitalOcean beispielsweise nicht der Fall ist, daher empfehle ich ohnehin die Verwendung der Overlay Verschlüsselung!).

Nehmen wir an, wir haben den folgenden Stack:

version: '3'
services:
  db:
    networks:
      - internal
    image: mysql:5.7
    environment:
      MYSQL_DATABASE: wordpress
      MYSQL_USER: wordpress
      MYSQL_PASSWORD: securepw
  wordpress:
    networks:
      - traefik_public
      - internal
    depends_on:
      - db
    image: wordpress:latest
    environment:
      WORDPRESS_DB_HOST: db:3306
      WORDPRESS_DB_USER: wordpress
      WORDPRESS_DB_PASSWORD: securepw
    deploy:
      labels:
        - traefik.frontend.rule=Host:blog.example.com
        - traefik.docker.network=traefik_public
        - traefik.port=80
networks:
  traefik_public:
    external: true
  internal: 

 
Das ist ein WordPress-Stack, das die WP-Seite und eine MySQL-Datenbank erstellt. Diese zwei Netzwerke sind wie folgt definiert:

  • intern
  • traefik_public

Das interne Overlay-Netzwerk wird für die Kommunikation zwischen dem WP-Container und der Datenbank verwendet. Dieses Netzwerk ist von aussen nicht erreichbar. traefik_public ist das Netzwerk, das für den Reverse-Proxy verwendet wird. Es wird nur an den WP-Container angehängt, da dies die einzige öffentlich zugängliche Seite dieses Setups ist.
Das Problem hier ist: Ohne ein gesichertes privates Netzwerk wird der Verkehr, der durch das interne Netzwerk läuft, an einen anderen Worker (Docker-Node) weitergeleitet, und das vollständig offen. Jedes Passwort / Authentifizierung / <SENSITIVE_DATA> wird im Klartext zwischen den Docker Containern gesendet, sofern sie sich auf zwei unterschiedlichen Nodes befinden.
Die meisten Docker-Images sind in ihrer einfachen Verwendung nicht für den öffentlichen Zugriff gedacht und deshalb halten sie die meisten so einfach wie möglich, ohne komplizierte Verschlüsselung. Du kannst aber auch ein eigenes Image erstellen, um die Applikationsseitige Verschlüsselung zu aktivieren.

Die Lösung

Docker hat eine Lösung für dieses Problem. Die Verschlüsselung des Overlay-Netzwerks kann einfach aktiviert werden. Leider habe ich zu diesem Thema nicht viel finden können, weshalb ich dachte, dass ein Blogbeitrag zu diesem speziellen Thema nützlich sein könnte.
Die Verschlüsselung des Netzwerks muss während der Erstellung erfolgen. Ein Netzwerk kann nicht mehr verschlüsselt werden, nachdem es bereits eingerichtet wurde. Um die Verschlüsselung zu aktivieren, müssen wir der Netzwerkdefinition ein Flag hinzufügen:

networks:
   traefik_public:
     external: true
   internal:
     driver_opts:
       encrypted: ""

Das Netzwerk traefik_public ist natürlich auch verschlüsselt, da du das Reverse-Proxying natürlich auch nicht im Klartext willst.
Die Option encrypted erstellt einen IPSec-Tunnel zwischen allen Worker, für die Aufgaben für einen Stack geplant sind. Dadurch wird der gesamte Traffic des Overlay-Netzwerks intern verschlüsselt und ermöglicht so den Datenaustausch sensitiver Daten zwischen der Datenbank und WordPress.
Du kannst die offizielle Dokumentation von Docker zu diesem Thema hier nachlesen.

Abschliessende Gedanken

Die Informationen in Bezug auf die Verschlüsselung sind sehr „versteckt“ und werden meiner Meinung nach meistens ignoriert. Die Leute möchten einfach Anwendungen mit Docker deployen, ohne sich über die darunter liegende Infrastruktur Gedanken machen zu müssen und stossen so auf das Problem wie bspw. Plain-Text Traffic in Overlay-Netzwerken.
Ich hoffe, mit diesem Blog-Post mehr auf Verschlüsselung aufmerksam machen zu können.
Wenn du Fragen dazu hast, lass es mich gerne weiter unten wissen!

Elia Ponzio

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Tech

Hosting Drupal on Openshift with the help of Lagoon – by Bastian Widmer (Amazee.io)

3. Juni 2018

Amazee.io machte es sich zum Ziel, das Hosting von Drupal-Websites einfacher und flexibler zu gestalten. Wir sind stets bestrebt, auf dem neuesten Stand der Technik zu bleiben. Es überrascht daher nicht, dass wir einen containerbasierten Ansatz für das Hosting eingeführt haben. In diesem Blog werden wir darüber sprechen, was Container sind und warum wir glauben, dass es wichtig ist, einen Schritt weiter zu gehen und unsere Technologie, die wir zum Hosten von Websites nutzen, zu öffnen.


(diesen Blog gibt’s nur auf Englisch)

What Does Hosting Without Containers Look Like?

First and foremost, it’s less flexible. If your project has special needs (i.e. caching with redis or a decoupled frontend with node.js)that your provider does not support, you might end up in a tricky situation.

You might have to either add another provider that supports your technology or you find another provider which hosts your project on one platform.

Adding another provider to the mix ads more complexity and less streamlined support structures if you ever run into issues. amazee.io’s new system, Lagoon, gives developers the flexibility to create their own service architecture, supporting everything from a simple Drupal website to a high traffic website with a decoupled frontend and server side rendering. We do this with through the magic of containers.

So, what are containers?

You can think about hosting companies as shipping companies and the servers we have are ships that hold the code from individual projects.

Before the standard shipping container existed it was quite an endeavour to load and unload a ships cargo because everything had custom dimensions – so stacking them in an efficient manner was really hard.As soon as a standard was established – in this case the shipping container – everything got much easier because they were stackable and had all the same form factor.

This allegory shows that the age of custom servers is over. Sure you can run a lot of things on a server but it will not scale past a certain degree. Containerizing your applications makes it much easier to move between platforms because you follow a certain standard.

You can see why hosting companies solve this by only hosting one kind of thing. Drupal sites, for example. But the beauty of containers is that we can host all sorts of projects and still make everything efficient and optimized for our ships. We do this with the help of container technology.

Open source

We’re entering the third decade of open source as the Open Source Initiative celebrated its 20th anniversary beginning of February 2018. From the very beginning, amazee.io was committed to  basing our work open source software and technologies as much as possible.  This enabled us to continue the great work started byother projects and bring innovative solutions a step further our solutions a step further.

Every version of our hosting system is more flexible than the last, with more  functionality for our clients. We always saw it a bit troubling that we host open source CMS like Drupal or WordPress on proprietary solutions where you don’t know what happens behind the curtains. Last year we decided to go one step further and we have open sourced our Docker in Production hosting System. It’s there for everyone to look at it, understand it, tinker with it. We welcome feedback, contributions, and high fives at all times.

You can find more about our Project on our Website or if you want to talk about hosting we’re always there for you on our Slack

Aarno Aukia

Aarno ist Mitgründer der VSHN AG und als CTO für die technische Begeisterung zuständig.

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Tech

Automatisierte Build-Pipelines mit GitLab CI und APPUiO

1. Apr. 2018

Update: Demo-Projekte veröffentlicht

Dieser Blogpost ist unterdessen veraltet. Wir haben neue Demo-Projekte mit Source-Code, öffentlicher CI/CD pipeline und Kubernetes-Integration vorbereitet: https://gitlab.com/appuio und wir sind gespannt auf Dein Feedback in Form von Issues und Merge Requests!

Zusammenfassung

„Deploy early and often“ ist einer der wichtigsten Grundsätze von agiler Entwicklung. Eine Lösung für dieses Problem sind automatisierte Build- und Deployment-Pipelines.
Bei diesem Projekt kommt eine solche Pipeline zum Einsatz, basierend auf GitLab CI und OpenShift. Es wird eine PHP-Beispielanwendung entwickelt und auf APPUiO deployt.
Es werden drei Umgebungen in Form von OpenShift-Projekten genutzt: test, qual und production. Dabei handelt es sich um das gängigste Set-up, allerdings lässt sich das anpassen und einfach erweitern. Die Idee besteht darin, jeden Commit auf den master Branch automatisch für die test-Umgebung zu builden und zu deployen. Wird ein Git-Tag erstellt, wird das zuvor generierte Docker-Image mit dem Git-Tag markiert und automatisch auf die qual-Umgebung deployt. Das Deployment für die production-Umgebung erfolgt hingegen manuell und kann über GitLab ausgelöst werden.

Pipelines

In der .gitlab-ci.yml Datei sind zwei Pipelines definiert: Eine wird für jeden Commit auf den Master-Branch ausgeführt und setzt sich aus den Phasen lint, build und deploy-test zusammen. Bei der lint-Phase wird ein Docker-Container gestartet, in dem der PHP-Code auf korrekte Syntax überprüft wird. Während der build-Phase wird ein neuer OpenShift-Build (S2I) aufgerufen. In der letzten Phase wird das erstellte Image für die test-Umgebung deployt.
Die zweite Pipeline wird beim Erstellen eines Git-Tags gestartet. Sie setzt sich aus den Phasen release, deploy-qual und deploy-production zusammen. Während der ersten Phase wird das Docker-Image, das für den entsprechenden Git-Commit erstellt wurde, mit dem Namen des erstellten Git-Tags markiert. In der deploy-qual-Phase erfolgt das automatische Deployment des markierten Docker-Image in die qual-Umgebung. Die deploy-production-Phase muss manuell gestartet werden und deployt in die production-Umgebung.

APPUiO

Die Anwendung und der Build werden auf APPUiO ausgeführt. Das ermöglicht es uns, die Konzepte und Lösungen zu nutzen, die OpenShift für die Arbeit mit Builds und Deployments bietet. Im Verzeichnis openshift sind die YAML-Dateien enthalten, die die verwendeten OpenShift-Ressourcen beschreiben. Diese Dateien und der Code befinden sich im gleichen Git-Repository. Das garantiert, dass immer die gleiche Code-Version unter Verwendung der gleichen Version der OpenShift-Ressourcen erstellt und deployt wird.

Build

OpenShift BuildConfig ist Bestandteil des Build. Dafür wird ein PHP source-to-image builder genutzt und ein Docker-Image erstellt, in dem die Anwendung enthalten ist. Das Image wird mit dem Git-Commit-Hash markiert und in der OpenShift-Docker-Registry gespeichert.

BuildConfig
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
apiVersion: v1
kind: BuildConfig
metadata:
  labels:
    app: ${APPNAME}
  name: ${APPNAME}
spec:
  strategy:
    type: Source
    sourceStrategy:
      from:
        kind: ImageStreamTag
        name: 'php:7.0'
        namespace: openshift
      incremental: true
  source:
    git:
      ref: ${COMMIT_SHA}
      uri: ${REPOSITORY_URL}
    type: Git
  output:
    to:
      kind: ImageStreamTag
      name: '${APPNAME}:${APP_TAG}'

Deployment

Für die Ausführung der Anwendung wird DeploymentConfig genutzt. Dank der rolling Deployments lassen sich Systeme ohne Ausfallzeiten ausrollen und Endbenutzer werden nicht durch Unterbrechungen für Updates gestört. Anhand von liveness- und readiness Checks kann OpenShift testen, ob der Container korrekt ausgeführt wird (liveness), und den eingehenden Datenverkehr zulassen (readiness). Darüber hinaus werden ein OpenShift-Dienst und eine Route erstellt, um den Datenverkehr von ausserhalb des Clusters zur Anwendung zu routen. Für jede Umgebung wird eine eigene URL festgelegt, die sich aus GitLab heraus öffnen lässt.

DeploymentConfig
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
apiVersion: v1
kind: DeploymentConfig
metadata:
  name: ${APPNAME}
spec:
  replicas: 1
  selector:
    app: ${APPNAME}
  strategy:
    type: Rolling
  template:
    spec:
      containers:
      - name: ${APPNAME}
        image: "docker-registry.default.svc:5000/${OPENSHIFT_PROJECT}/${APPNAME}:${APP_TAG}"
        imagePullPolicy: Always
        ports:
        - name: web
          containerPort: 8080
        livenessProbe:
          httpGet:
            path: /
            port: web
        readinessProbe:
          tcpSocket:
            port: web
      restartPolicy: Always


Demo

Drei Dinge sind erforderlich, um die Pipeline in Aktion sehen zu können:

  1. Ihr eigener fork des Repository in GitLab, mit aktiviertem GitLab CI.
  2. Ein Projekt in APPUiO für jede Phase: test, qual und production
  3. Ein Service-Account mit edit-Berechtigungen für alle Projekte

Schritt für Schritt

  1. Einrichtung einer Kubernetes-/OpenShift-Integration in GitLab: https://docs.gitlab.com/ce/user/project/clusters/index.html#adding-an-existing-kubernetes-cluster
  2. Konfiguration von .gitlab-ci.yaml für Ihre APPUiO-Projekte
  3. Commit und Push der Änderungen
  4. Build der Anwendung durch die automatisierte Pipeline und Deployment der Anwendung für das test-Projekt
  5. Erstellung eines Git-Tags
  6. Erstellung von Image-Tags durch die automatisierte Pipeline und Deployment der Tags für das qual-Projekt
  7. Manuelle Ausführung eines Deployments für die production-Umgebung durch Aufrufen der Pipeline in GitLab und das Klicken auf die Schaltfläche zum Abspielen des deploy:production-Jobs

Ausblick

Eine mögliche Erweiterung dieses Set-ups wären automatische Deployments von Feature-Branches. Damit wird jeder Merge-Request gebuildet, und eine Live-Version der Anwendung steht zum Testen der implementierten Änderungen bereit. So lassen sich Änderungen ganz einfach überprüfen und testen.
Weitere Informationen zu automatisierten Builds und Deployments mit GitLab und APPUiO werden unter Dokumente bereitgestellt. Unter APPUiO Public besteht die Möglichkeit, ein Projekt zu erstellen.

Aarno Aukia

Aarno ist Mitgründer der VSHN AG und als CTO für die technische Begeisterung zuständig.
Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Tech

APPUiO auf Microsoft Azure Cloud

15. März 2018

In the past few years, Microsoft has transformed itself from a classic Windows and Office provider to a modern cloud provider. The Azure Cloud has become a global hyperscale cloud platform with many interesting features. Red Hat has also recognized this and offers official support from OpenShift to Azure. Mit der Ankündigung von Microsoft die Azure Cloud auch in die Schweiz zu bringen, könnte dies für viele Schweizer Firmen ein interessantes Angebot sein. Als Microsoft Azure Partner für Open Source Software in der Schweiz zeigen wir anhand eines Beispiels wie OpenShift auf Azure installiert werden kann. Kurz gesagt: Funktioniert wunderbar.

Was haben wir gebaut?

Für uns ist die Automatisierung aller Aspekte von Installation, Konfiguration, Monitoring, Updates etc das Wichtigste für einen stabilen und skalierbaren Betrieb einer Infrastruktur. Dies gilt insbesondere für ein komplexes System wie OpenShift in der Cloud. Daher wollen wir zeigen, wie einfach, schnell und automatisiert sich alle notwendigen Komponenten einrichten lassen. Dafür haben wir uns an den Referenz Architektur Guide gehalten.

Desweiteren wollten wir in Erfahrung bringen, welche Azure Services benutzt werden können und wieviele Pods wir ohne Tuning laufen lassen können.

Wie hat es funktioniert?

Der Referenz Architektur Guide orchestriert alle Komponenten mit Ansible. Die Infrastruktur Komponenten auf Azure werden dabei mittels der offiziellen Ansible Integration unter Zuhilfenahme des Azure Resource Manager aufgesetzt. Anschliessend übernimmt das offizielle OpenShift Ansible Playbook die Arbeit und installiert und konfiguriert OpenShift.
Benutzt werden eine ganze Reihe von Azure Services:

  • Availability set
  • Load balancer
  • Network interface
  • Network security group
  • Public IP address
  • Storage account
  • Virtual machine
  • Virtual network

Bei dieser grossen Anzahl zu pflegender Services kommt man um Automatisierung nicht herum. Mittels Ansible lässt sich das sehr gut bewerkstelligen.

Mit den 9 provisionierten Nodes dieses Beispiels haben wir einen Demo-Service erfolgreich auf 300 Pods skaliert:

Unser Fazit

OpenShift auf Azure ist eine gute Wahl. Die Azure Cloud bietet sehr viele essenzielle Services, welche einen reibungslosen Betrieb von OpenShift ermöglichen. Gerne unterstützen wir Sie bei Ihrem Azure Cloud Projekt.

Tobias Brunner

Tobias Brunner arbeitet seit über 20 Jahren in der Informatik und seit bald 15 Jahren im Internet Umfeld. Neue Technologien wollen ausprobiert und darüber berichtet werden.

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt