Allgemein Event Tech

Ein Tag mit Open-Source-Legenden: Technical Roadshow MariaDB & VSHN mit Michael “Monty” Widenius & Anders Karlsson

28. Okt. 2026

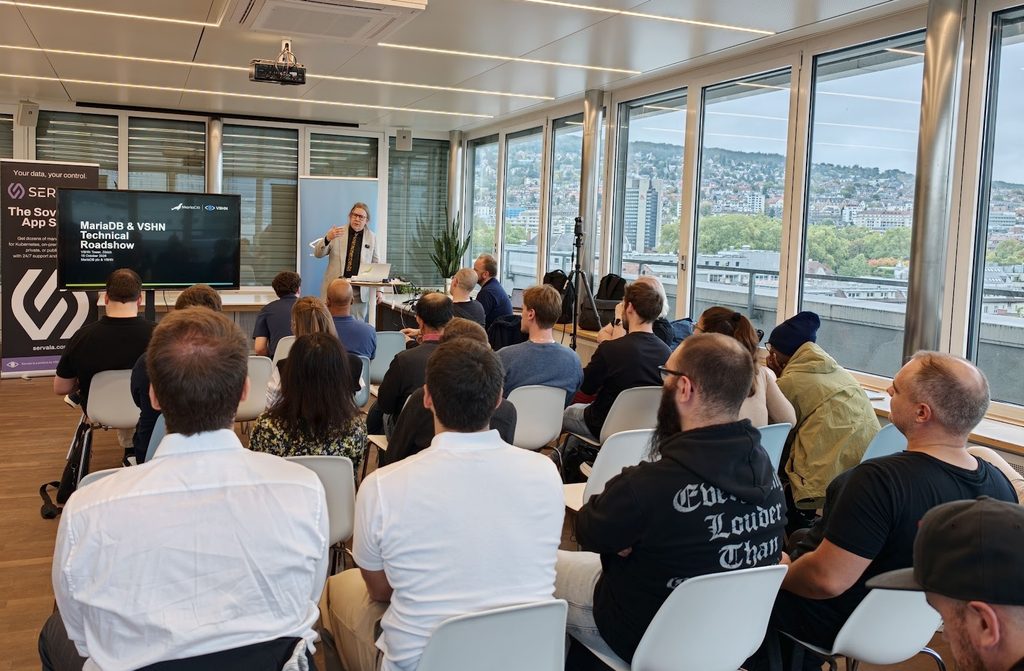
Ein ausgebuchter VSHN Tower, Monty Widenius, der die Geschichte von MySQL und MariaDB aus erster Hand erzählt, Anders Karlsson mit Live-Demos und Computergeschichte – und eine Roadmap, bei der der ganze Raum zum Smartphone griff, um Fotos zu machen. Manche Events bleiben einfach in Erinnerung – unsere Technical Roadshow MariaDB & VSHN am Montag, 19. Oktober 2026, war eines davon.

Der Raum war voller Leute, die mit echten Fragen kamen und unsere Speaker haben dreieinhalb Stunden Datenbank-Talk in einen der unterhaltsamsten Nachmittage verwandelt, die wir je im VSHN Tower hatten. Fast alle sind bis ganz zum Schluss geblieben – und danach noch ein bisschen länger für den Apéro. Das sagt mehr als jedes Feedback-Formular.

Live-Demos mit “Dr. Database”
Anders Karlsson, Solutions Engineer bei MariaDB und für viele schlicht “Dr. Database”, hat den Nachmittag mit zwei Live-Demos eröffnet. Zuerst: ein MariaDB Galera Cluster mit MaxScale davor. MaxScale ist der SQL-fähige Proxy zwischen Applikation und Datenbank – er trennt Lese- und Schreibzugriffe, übernimmt das Failover transparent und spielt sogar laufende Transaktionen erneut ab, damit die Applikation nicht merkt, wenn ein Node ausfällt.
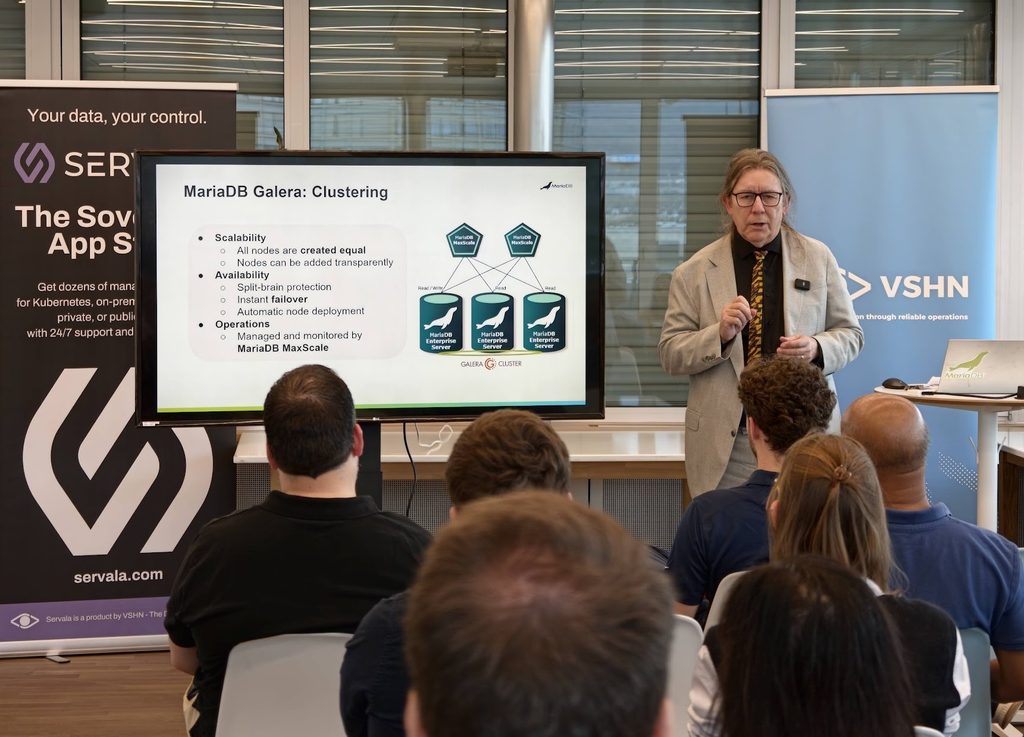
In der zweiten Demo zeigte Anders MariaDB Cloud und die KI-Seite von MariaDB: native Vektorsuche, RAG-Pipelines und MCP für KI-Agenten. Die Vektorsuche ist seit Version 11.8 fest in MariaDB eingebaut – keine Extension nötig, die Embeddings liegen direkt neben den Daten, die sie beschreiben, und die semantische Suche läuft in ganz normalem SQL. Auch die Benchmarks waren beeindruckend: zwei- bis dreimal so viele Queries pro Sekunde wie pgvector bei gleichem Recall und ein Index, der in unter 15 Minuten statt in mehreren Stunden gebaut ist.

Anders ist nicht nur Datenbankexperte, sondern auch ein grosser Fan von Computergeschichte – und ein toller Geschichtenerzähler. Einer unserer Lieblingsmomente war seine Geschichte darüber, wie IBM die Zukunft des Unternehmens auf einen einzigen Computer gesetzt hat. Es hat funktioniert – und nur deshalb kennen wir heute alle den Namen IBM. Wäre es schiefgegangen, wäre IBM heute wohl nur eine Fussnote in einem Geschichtsbuch.

KI für Datenbanken, auf Schweizer Clouds
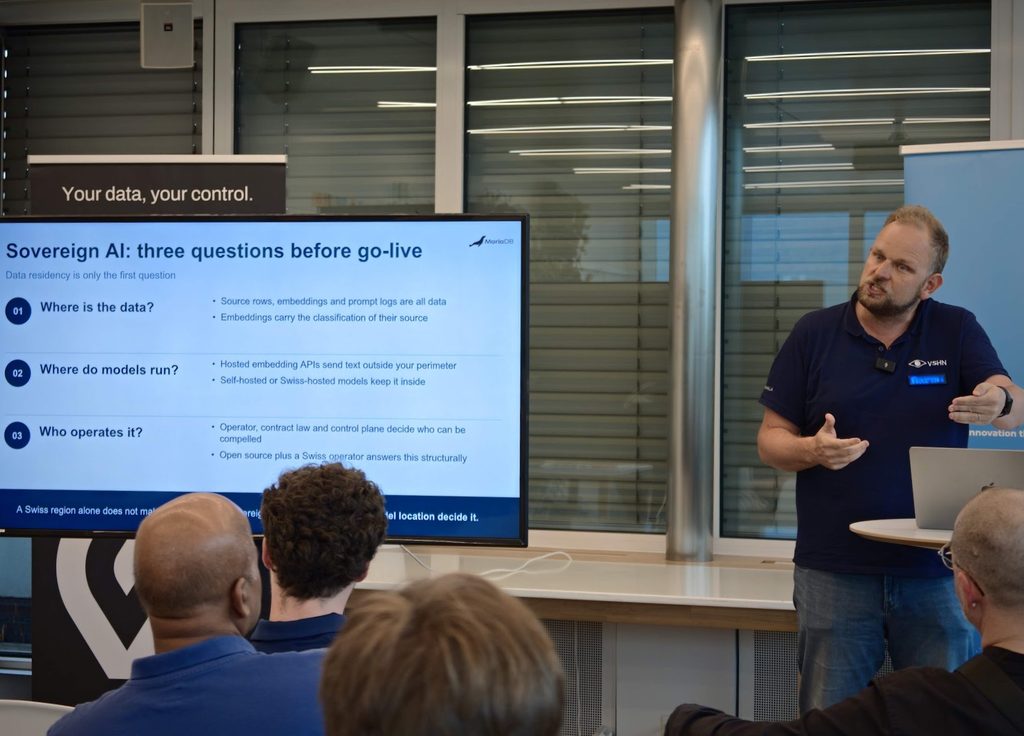
Nach der Pause hat Aarno Aukia KI aus Sicht des Betreibers betrachtet. Wenn KI-Agenten mit Datenbanken arbeiten, passieren zwei ganz unterschiedliche Dinge: Agenten verbinden sich mit deinen bestehenden Datenbanken – mit Query-Mustern, die nie jemand geprüft hat. Und Agenten provisionieren ihre eigenen Datenbanken – die niemand bestellt hat, niemand patcht und niemand sichert. Mit dem VSHN Application Catalog ist eine Datenbank einfach ein Kubernetes-Objekt, und RBAC, Quotas und Namespaces werden zur Policy – in deinem Cluster, auf deiner Schweizer Cloud, mit deinem Audit-Trail.

Ausserdem hat er die Frage gestellt, die sich jede Organisation stellen sollte, bevor ein KI-Workload live geht: Ist er wirklich souverän? Eine Schweizer Region allein reicht nicht. Entscheidend ist, wo die Daten liegen (inklusive Embeddings und Prompt-Logs), wo die Modelle laufen und wer das Ganze betreibt. Open Source plus ein Schweizer Betreiber beantwortet die letzte Frage strukturell.
Aarno zeigte auch die drei Wege, MariaDB mit VSHN zu betreiben: als Self-Service über den souveränen App Store Servala, direkt von VSHN auf APPUiO oder VSHN Managed OpenShift, oder in deiner eigenen Private Cloud oder deinem Rechenzentrum. Und weil VSHN autorisierter Schweizer Reseller ist, gibt es MariaDB Enterprise auf derselben Plattform – mit dem Service Level von VSHN für die Plattform und dem von MariaDB für die Datenbank.

Die Geschichte von MySQL und MariaDB – erzählt von dem, der sie geschrieben hat
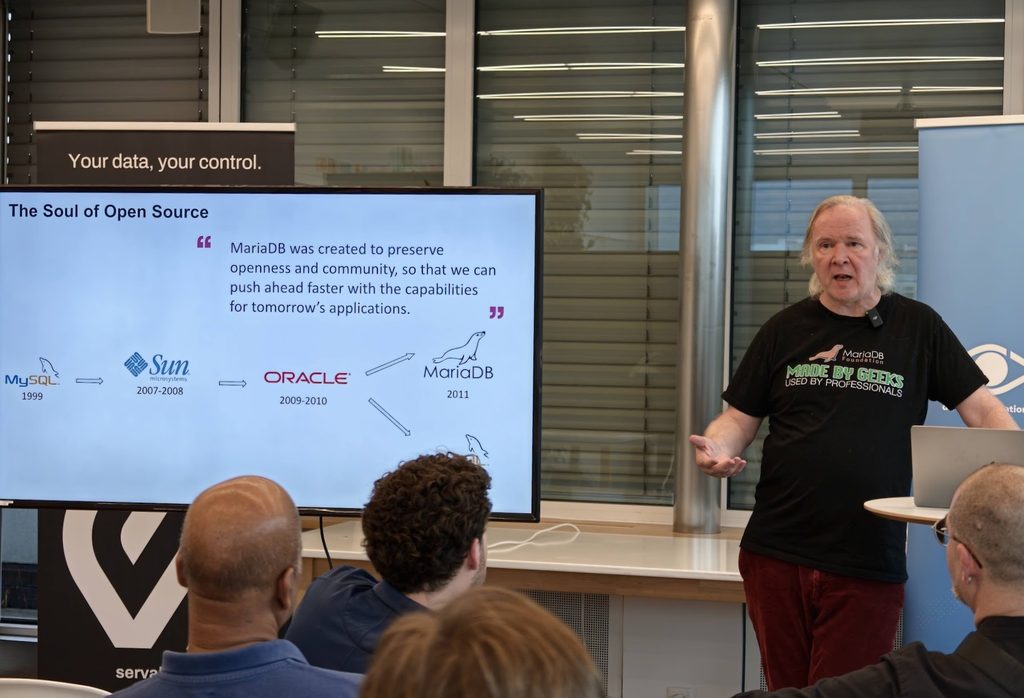
Dann kam das Highlight des Nachmittags: 75 Minuten mit Michael “Monty” Widenius, CTO von MariaDB plc und Schöpfer von MySQL und MariaDB.

Monty hat uns ganz an den Anfang mitgenommen: wie er MySQL gebaut hat und wie aus einem kleinen nordischen Projekt das “M” im LAMP-Stack wurde, auf dem ein grosser Teil des frühen Webs lief. Dann kam 2008 der Verkauf an Sun Microsystems. Monty war da ganz offen: Er war überzeugt, dass Sun das perfekte Zuhause für MySQL war – ein Unternehmen mit Open Source im Kern. Und wenn eines in jeder Minute seines Talks rüberkam, dann wie tief Monty an Open Source glaubt. Nicht als Geschäftsmodell, sondern als die richtige Art, Software zu bauen.
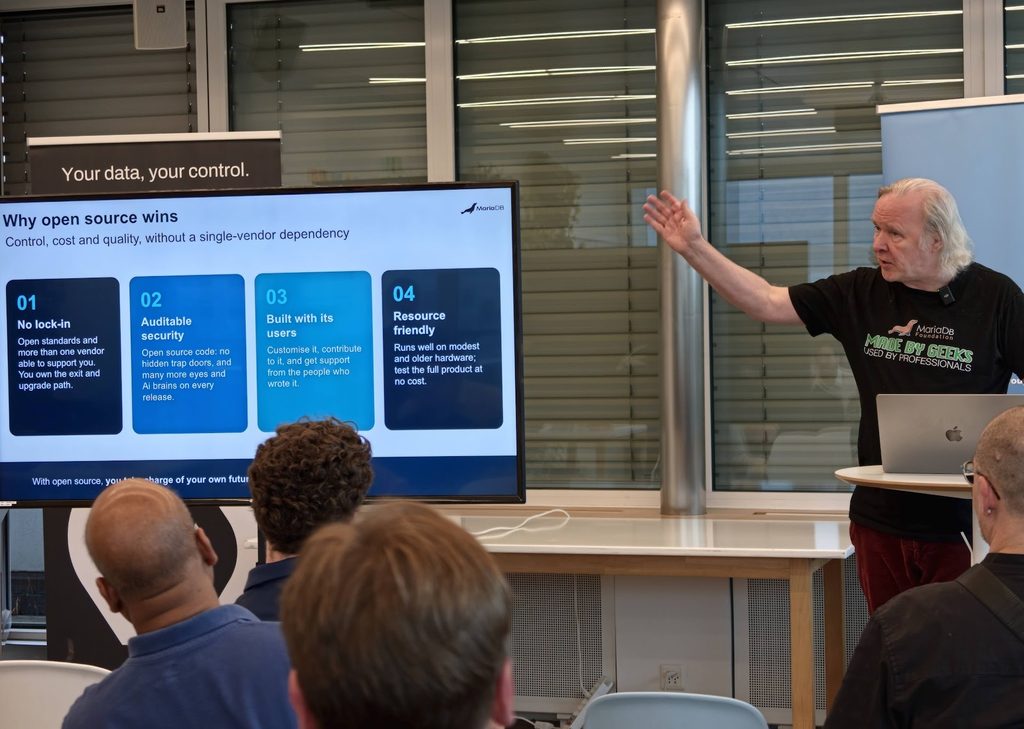
Dann kündigte Oracle an, Sun zu übernehmen – und damit auch MySQL. Für Monty änderte das alles. Also beschloss er, es noch einmal zu tun. Er forkte den Code, viele der zentralen MySQL-Entwickler folgten ihm, und MariaDB war geboren – benannt nach seiner jüngeren Tochter Maria, so wie MySQL nach seiner Tochter My benannt ist.

Diese Geschichte aus erster Hand zu hören, war etwas ganz Besonderes. Und Monty erzählt sie mit viel Humor – der Raum hat mehr als einmal gelacht. Zusammen sind Monty und Anders ein fantastisches Team: auf der einen Seite die Perspektive des Gründers, auf der anderen die von Dr. Database.

Als der ganze Raum zum Smartphone griff
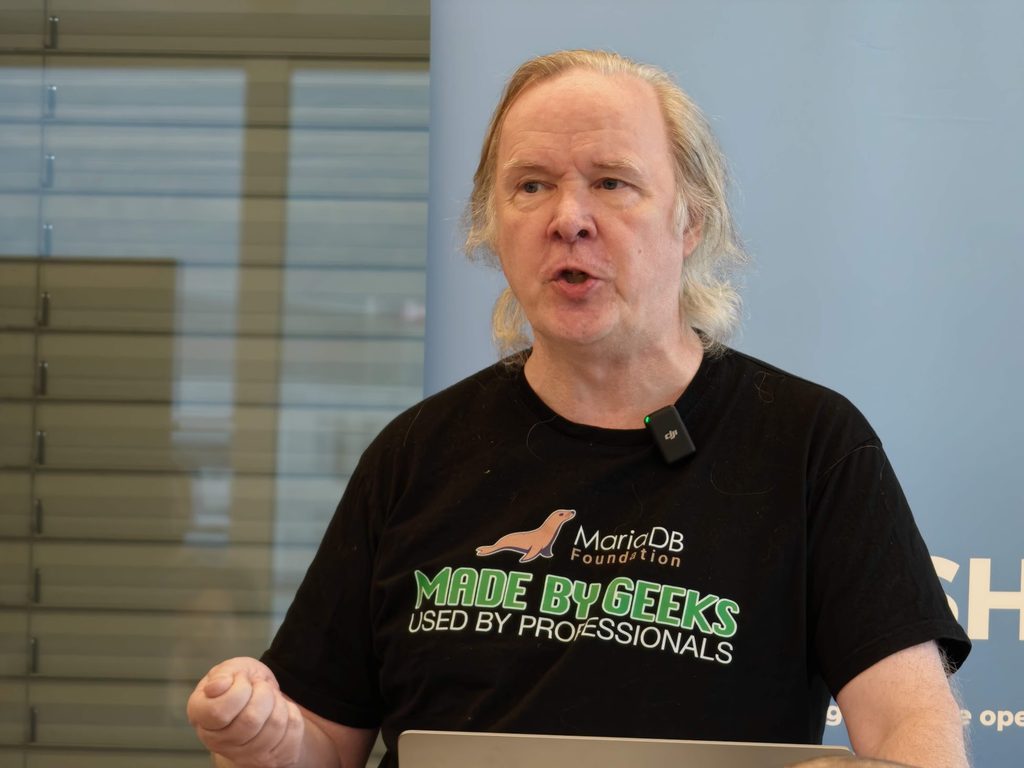
Monty hat aber nicht nur zurückgeschaut. Als er zeigte, was in den nächsten MariaDB-Releases kommt, passierte etwas, das man an Tech-Events selten erlebt: Der ganze Raum zückte das Smartphone, um die Slides zu fotografieren. Ein paar der Dinge, die dafür gesorgt haben:

  • MariaDB 13.0 (GA seit 15. September) mit einer DuckDB Storage Engine für Analytics direkt in MariaDB, RETURNING für Updates und Point-in-Time-Recovery aus dem Redo-Log
  • Performance: bis zu 2,5-facher OLTP-Durchsatz von 11.8 Enterprise im Vergleich zu 10.6 und 2- bis 4-facher Schreibdurchsatz auf HDD in 12.3
  • Plugins direkt aus SQL installieren, aus einem signierten Repository der MariaDB Foundation – neue Funktionen, ohne aufs nächste LTS warten zu müssen
  • MariaDB 14 und darüber hinaus: Parallel Query, Materialized Views, Row-Level Security, Full Outer Joins und mehr

Monty hat auch das Thema Migration abgedeckt: Der Umstieg von MySQL 5.7 oder älter ist in den meisten Fällen ein Drop-in-Replacement, MariaDB repliziert von und zu MySQL, sodass du parallel testen und dir einen Weg zurück offenhalten kannst, und mit sql_mode=ORACLE läuft viel PL/SQL unverändert.

Die Zukunft von Tech, Datenbanken und KI

Ein roter Faden durch den ganzen Nachmittag war die Zukunft: von Datenbanken, von Technologie allgemein und ganz besonders von KI. Ein Punkt, der uns geblieben ist: Large Language Models wirken, als wären sie aus dem Nichts gekommen, aber die Ideen dahinter gibt es schon lange.

Und es gab eine schöne Verbindung zurück zu den Anfängen von MariaDB. “Open Weights” sind nicht dasselbe wie Open Source – die Gewichte werden veröffentlicht, aber die Trainingsdaten bleiben unter Verschluss und die Lizenzen kommen mit Einschränkungen. Die Frage, aus der MariaDB entstanden ist, stellt sich heute bei KI-Modellen erneut. Apertus, das offene Schweizer Modell von ETH Zürich, EPFL und CSCS, wurde als Beispiel gezeigt, wie es auch anders geht.

Viele Fragen und ein toller Apéro

Das Publikum war super engagiert, und die offene Q&A am Schluss brachte viele spannende Fragen an die Engineers von MariaDB und VSHN. Und wie immer im VSHN Tower gingen die Gespräche danach beim Apéro mit Drinks und Fingerfood weiter.

Verpasst? Slides und Aufzeichnungen

Du hast keinen Platz mehr bekommen oder willst alles nochmals in Ruhe anschauen? Kein Grund, deine Smartphone-Fotos zu entziffern – Lade dir die Slides herunter vom ganzen Nachmittag. Die Aufzeichnungen der Talks sind bald auf vshn.tv online – wir sagen dir Bescheid, sobald sie verfügbar sind.

Danke
Ein riesiges Dankeschön an alle bei MariaDB, die das möglich gemacht haben – besonders an Monty, Anders und Jonas Schwegler, dass sie nach Zürich gekommen sind und so viel Zeit, Wissen und Geschichten mit uns geteilt haben. Danke an Aarno, Tania und alle VSHNeers, die vor Ort mitgeholfen haben. Und vor allem: Danke an alle, die gekommen sind und den Nachmittag mit uns verbracht haben. Ihr habt ihn zu dem gemacht, was er war.

Weiter geht’s: Executive Breakfast Roundtable am 17. November

Wenn du am Montag dabei warst, hast du gesehen, was MariaDB technisch kann. Der nächste Schritt ist das Business-Gespräch – und da kommt deine Chefin oder dein Chef ins Spiel.

Am 17. November laden wir zum Executive Breakfast Roundtable MariaDB & VSHN, wieder im VSHN Tower. Beim Frühstück sprechen wir darüber, wie MariaDB deiner Organisation helfen kann und wie VSHN es für dich betreibt – souverän, in der Schweiz, vollständig managed. Mit einer Customer Success Story und einem offenen Roundtable mit viel Raum für Fragen.

Darum unsere Bitte: Erzähl deiner Chefin oder deinem Chef davon. Leite ihnen diesen Beitrag weiter. Die Plätze sind auf 20 begrenzt.

Hier anmelden: https://luma.com/2nsyt1ud

Du willst nicht so lange warten? Hol dir einen kostenlosen Estate Review deines MariaDB- oder MySQL-Setups, schau dir managed-mariadb.ch an oder teste Managed MariaDB auf Servala.

Wir sehen uns im VSHN Tower!

Markus Speth

Marketing, Communications, People
Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Allgemein Security Tech

Katertag: eMudhra, PHP2Shell und GitLab – drei kritische Fixes an einem Tag

22. Okt. 2026

Heute fühlt sich an wie ein Katertag. Der Kopf ist schwer, der Kaffee stark und alle sind ein bisschen langsamer unterwegs. Nur haben wir letzte Nacht nicht gefeiert. Wir haben gepatcht – gleich dreimal. Am Morgen waren es kompromittierte Zertifikate, am Nachmittag PHP und spät in der Nacht GitLab.

Morgen: kompromittierte Zertifizierungsstellen

Jedes Mal, wenn du das Schloss-Symbol im Browser siehst, bestätigt eine Zertifizierungsstelle (Certificate Authority, CA), dass die Website wirklich die ist, die sie vorgibt zu sein. Kommt ein Angreifer an die Schlüssel einer CA, kann er sich als beliebige Website ausgeben.

Genau das ist bei eMudhra passiert. Laut Google hat ein Sicherheitsforscher gemeldet, dass die privaten Schlüssel von acht Zwischenzertifikaten (Intermediate CAs) von eMudhra mit unzureichender Zufälligkeit erzeugt wurden – womit es für jeden möglich war, vertrauenswürdige HTTPS-Zertifikate für beliebige Websites zu fälschen. Chrome hat die betroffenen CAs innerhalb weniger Stunden nach der Meldung blockiert, und Google wird das zugehörige Root-Zertifikat am 27. Oktober, also nächsten Dienstag, aus dem Chrome Root Store entfernen.

Browser konnten das schnell beheben. Alles andere nicht. Wie Cloudflare erklärt, prüft sehr viel Software Zertifikate gegen einen eigenen Trust Store – im Betriebssystem, in Laufzeitumgebungen von Programmiersprachen, in Container-Base-Images. All das muss aktualisiert, neu gebaut und neu gestartet werden. Genau diese Art von Arbeit landet bei einem Platform-Team, und am Morgen des 21. Oktober hat das ganze VSHN-Team am CA-Fix gearbeitet.

Nachmittag: PHP2Shell

Unsere Engineers waren also schon gut ausgelastet, als das nächste Problem auftrat. Am 21. Oktober haben die PHP-Entwickler Notfall-Sicherheitsupdates veröffentlicht für zwei kritische Schwachstellen im PHP-Kern-Interpreter, CVE-2026-109618 und CVE-2026-109619. Beide sind mit 9.2 bewertet und erlauben es einem nicht authentifizierten Angreifer, auf einem betroffenen Webserver aus der Ferne Code auszuführen. Erschwerend kam hinzu, dass Details bereits am 20. Oktober online geleakt wurden – vor der koordinierten Veröffentlichung und bevor Patches verfügbar waren. Die Schwachstellen laufen inzwischen unter dem Namen “PHP2Shell”, und die Empfehlung der Sicherheitsbehörden war unmissverständlich: sofort patchen oder exponierte Anwendungen vom Netz nehmen. Die PHP Foundation hat einen eigenen Beitrag zum Release veröffentlicht und dazu, wie sie die Sicherheit von PHP künftig stärken will.

Das war kein theoretisches Risiko. Ein Hosting-Anbieter berichtete, dass Angreifer ab 08:44 UTC an jenem Morgen mit einem öffentlichen Proof-of-Concept-Exploit Anfragen an die von ihm gehosteten WordPress-Sites geschickt haben.

Was PHP ist und was darauf läuft

PHP ist eine Programmiersprache fürs Web. Sie läuft auf dem Server und baut Seiten im Moment des Aufrufs zusammen – holt Inhalte aus einer Datenbank, prüft, ob du eingeloggt bist, erzeugt das HTML und schickt es an deinen Browser. Rund 70% aller Websites laufen mit PHP. Einige der bekanntesten Anwendungen darauf:

  • WordPress, inklusive WooCommerce-Onlineshops
  • MediaWiki, die Software hinter Wikipedia
  • Drupal
  • Joomla
  • TYPO3
  • Magento und Shopware
  • Nextcloud

Der Fehler steckt in PHP selbst, nicht in einer dieser Anwendungen oder ihren Plugins. WordPress, TYPO3 oder Nextcloud aktuell zu halten, hat also nicht geschützt. Betroffen ist jede PHP-Version der letzten zehn Jahre, zurück bis Version 5.4.

Wie wir und unsere Kunden auf PHP2Shell reagiert haben

Es gibt viele Beiträge, die erklären, was in PHP kaputt war. Spannender finden wir, was in der Praxis passiert, wenn so etwas einschlägt – deshalb hier, wie der gestrige Tag bei uns aussah.

Unser Team hat am Abend des 20. Oktober mit dem Monitoring begonnen, sobald das PHP-Projekt das anstehende Release angekündigt hatte. Die Kubernetes- und OpenShift-Plattformen, die wir für unsere Kunden betreiben, laufen selbst nicht auf PHP. Aber PHP taucht an vielen Stellen auf und rund um diese Plattformen auf, deshalb haben wir das als Major Incident über alle unsere Managed Services behandelt.

Kurz vor Mittag am 21. Oktober hat uns ein Kunde angerufen und gebeten, seine Website offline zu nehmen, bis der Fix da ist.

Auch unsere eigene Website vshn.ch war offline, vom 21. Oktober um 16 Uhr bis zum 22. Oktober um 4 Uhr morgens – 12 (!) Stunden Downtime. vshn.ch wird bei cyon.ch gehostet, einem der grössten Schweizer Webhoster, und cyon hat proaktiv alle PHP-Websites abgeschaltet, um sie zu schützen, bis PHP gepatcht war. Das sieht man nicht alle Tage – ein ganzer Hosting-Anbieter, der vorsorglich bei allen PHP-Sites gleichzeitig den Stecker zieht. Aber das könnten wir in Zukunft öfter sehen, wenn der nächste tief verborgene Fehler in einem gemeinsamen Fundament auftaucht und schnelles Patchen die einzige echte Verteidigung ist.

Sobald der Fix öffentlich war, haben wir alles andere aktualisiert. Auf virtuellen Maschinen mit PHP haben wir aktualisiert, sobald Ubuntu und Red Hat gepatchte Pakete bereitgestellt haben. Die Docker-Images, die wir pflegen, werden neu ausgerollt, sobald gepatchte Base-Images verfügbar sind. Und wo Kunden eigene PHP-Apps in Containern auf unseren Clustern betreiben, mussten auch diese Images gepatcht werden – deshalb haben wir diese Kunden gebeten, sie mit einer gepatchten PHP-Version neu zu bauen und neu auszurollen. Alle Details findest du auf unserer Statusseite.

mod_php vs. PHP-FPM: nicht jedes Setup hatte dasselbe Risiko

Alle gängigen Arten, PHP für Web-Anfragen zu betreiben, waren betroffen: Apache mit mod_php, PHP-FPM, php-cgi, FrankenPHP und LiteSpeed. Wie man PHP betreibt, war aber trotzdem wichtig. Laut den PHP-Entwicklern war das Risiko bei Setups mit Apache und mod_php am höchsten – dort haben sie einen Exploit demonstriert, der greift, bevor überhaupt Anwendungscode läuft. Bei uns kommt PHP-FPM zum Einsatz. PHP-FPM war allerdings ebenfalls betroffen, und Patchen war die einzige vollständige Lösung.

Nacht: GitLab

Als wäre der Tag nicht schon spannend genug gewesen: Spät in der Nacht hat GitLab Fixes für eine kritische Schwachstelle veröffentlicht – CVE-2026-110264, bewertet mit 10.0, dem Maximum. Damit kann ein Angreifer ohne Login Code auf einem selbst betriebenen GitLab-Server ausführen. Betroffen sind alle Versionen zurück bis 7.0 aus dem Jahr 2014, weil der Fehler in der Regex-Engine steckt, die GitLab seit jeher mitliefert. Unsere VSHNeers haben auch das gefixt.

Was wir daraus mitnehmen

Drei sehr unterschiedliche Probleme, ein gemeinsamer Nenner: Keines davon steckte in den Anwendungen, die man jeden Tag nutzt. Sie lagen in den Schichten darunter – in den Zertifikaten, die HTTPS vertrauenswürdig machen, in der Sprache, auf der der Grossteil des Webs läuft, in der Regex-Engine einer Entwicklerplattform. Jede Software, die wir betreiben, sitzt auf Schichten von Code, den jemand vor Jahren geschrieben hat und den die meisten von uns nie anschauen. Es ist leicht, jetzt mit dem Finger auf eMudhra, PHP oder GitLab zu zeigen. Bitte nicht. Heartbleed hat 2014 OpenSSL getroffen, Log4Shell 2021 die Java-Welt. Das kann jedem Fundament passieren, auf dem wir alle aufbauen.

Der KI-Aspekt

Was PHP2Shell besonders macht, ist, wie die Schwachstelle gefunden wurde. Der verwundbare Code war seit über zehn Jahren vorhanden, aber ihn auszunutzen erforderte eine aussergewöhnlich komplexe Kette von Schritten – am Rand dessen, was menschliche Forschende praktisch leisten können. Moderne KI-Modelle haben diese Hürde deutlich gesenkt. Laut den Forschenden von Wiz hat ein einzelner Forscher in einer Woche geschafft, wofür früher ein Weltklasse-Team Monate gebraucht hätte.

Das ist zugleich beängstigend und eine gute Nachricht. Beängstigend, weil “zu kompliziert zum Ausnutzen” kein Sicherheitsnetz mehr ist – Angreifer haben dieselben Werkzeuge. Gut, weil auch die Verteidiger solche tief vergrabenen Fehler jetzt schneller finden und beheben können, bevor jemand anderes sie ausnutzt. Wir sind ziemlich sicher, dass Tage wie gestern nicht selten bleiben. Rechne mit mehr davon, in mehr Sprachen, öfter. Damit zählt eines mehr denn je: wie schnell du patchen kannst.

Und an dieser Stelle möchten wir Danke sagen. Unsere VSHNeers waren schnell beim Patchen, und einige von ihnen könnten heute wirklich etwas Schlaf gebrauchen. Wenn dir also im nächsten Call jemand etwas müde vorkommt, weisst du jetzt, warum.

Was du tun solltest

Zu den Zertifikaten: Wenn deine Website ein Zertifikat nutzt, das auf emSign ECC Root CA – G3 zurückgeht, solltest du es laut Google sofort durch eines einer anderen CA ersetzen, bevor die Root am 27. Oktober aus Chrome entfernt wird. Über Browser hinaus: Aktualisiere die Trust Stores in Betriebssystemen, Laufzeitumgebungen und Container-Base-Images, baue die Images neu und starte die betroffenen Systeme neu. Und falls nach dem Patchen Zertifikatsfehler auftauchen: Behebe sie nicht, indem du die Zertifikatsprüfung abschaltest.

Zu PHP: Aktualisiere auf PHP 8.5.12, 8.4.27, 8.3.36 oder 8.2.35. Wenn du eine ältere Version nutzt: PHP 8.1 und älter erhalten möglicherweise keinen Fix – kläre das mit deinem Anbieter und plane das Upgrade jetzt. Wenn dein Server über ein Hosting-Panel wie cPanel verwaltet wird, kommen die gepatchten PHP-Versionen über die Updates des Panels – aktualisiere also das Panel, nicht nur deine Anwendung. Wenn du PHP in Containern betreibst, baue deine Images auf einer gepatchten Basis neu und rolle sie neu aus. Und denk daran: Ein Patch entfernt keine bereits erfolgte Kompromittierung – wirf also auch einen Blick in deine Logs.

Zu GitLab: Wenn du eine selbst betriebene Instanz hast, aktualisiere auf die gefixte Version für deinen Release-Branch.

Wenn du nicht sicher bist, ob etwas in deinem Stack betroffen ist, melde dich bei uns. Wir sind heute etwas müde, aber wir sind da.

Und jetzt: mehr Kaffee.

Markus Speth

Marketing, Communications, People
Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Allgemein Event Sovereignty Tech

Open Source im grossen Massstab: Warum Schweizer Organisationen eine souveräne Datenbankstrategie brauchen

15. Sep. 2026

MariaDB ist überall. Es steckt in unzähligen Linux-Distributionen, treibt Cloud-native Plattformen an und läuft still im Hintergrund vieler Applikationen, auf die Organisationen täglich angewiesen sind. Genau diese Allgegenwart ist der Grund, warum MariaDB mehr Aufmerksamkeit verdient, nicht weniger. Wenn Community-Builds vom „reicht schon“ zum geschäftskritischen System werden und KI-Workloads zusätzliche Anforderungen an die Datenschicht stellen, summieren sich die Risiken: nicht unterstützte Versionen, ungepatchte Schwachstellen, Lizenzunklarheiten und operative Reibung.

Genau das haben wir am 1. Oktober 2026 in einem gemeinsamen Webinar mit MariaDB angepackt. VSHN-Mitgründer Aarno Aukia hat mit Jonas Schwegler von MariaDB darüber gesprochen, wie digitale Souveränität in der Praxis konkret aussieht: nicht als Buzzword, sondern als Architekturentscheid für deine Datenschicht.

Du hast es verpasst? Kein Problem, die Aufzeichnung ist jetzt online.

Jetzt Aufzeichnung ansehen.

Darum geht es in der Aufzeichnung

  • Wie eine einheitliche MariaDB-Enterprise-Architektur zusammen mit MaxScale-Zero-Downtime-Failover genau die Zuverlässigkeit liefert, die Compliance-Vorgaben verlangen
  • Warum in der Schweiz gehostete OpenShift-Operations wichtig sind, wenn du ein souveränes Fundament für KI brauchst: RAG-Pipelines, native Vektorsuche und agentische Workloads, ganz ohne Public-Cloud-Lock-in
  • Wie du transaktionale, analytische und KI-Workloads in einer einzigen Engine konsolidierst und dadurch die ETL-Komplexität eliminierst, die entsteht, wenn separate Systeme nebeneinander laufen
  • Was es bedeutet, wenn dein Datenbank-Estate nativ innerhalb der Schweiz betrieben wird, mit direktem Zugang zum MariaDB-Engineering, wenn du ihn brauchst

Warum das gerade jetzt zählt

Open-Source-Datenbanken geben Organisationen Flexibilität und Kontrolle, aber nur, wenn sie bewusst gemanagt werden. Zu oft wachsen MariaDB-Community-Deployments organisch, bis niemand mehr genau weiss, welche Version wo läuft, ob sie gepatcht ist oder was passiert, wenn sie um drei Uhr morgens ausfällt. Souveränität heisst nicht nur, wo deine Daten liegen, sondern ob du wirklich für die Zuverlässigkeit, Sicherheit und Compliance der Systeme geradestehen kannst, die sie betreiben.

Triff Monty Widenius im VSHN Tower

Am Montag, 19. Oktober 2026, 13:30 bis 17:00 Uhr laden wir gemeinsam mit MariaDB zum Technical Workshop in den VSHN Tower in Zürich ein. Mit dabei sind MariaDB-Gründer Michael „Monty“ Widenius, Jonas Schwegler, Anders Karlsson sowie Aarno Aukia und Tobias Brunner von VSHN.

Das erwartet dich:

  • Live-Demo von MaxScale und MariaDB Cloud, inklusive BYOA/BYOC
  • Community vs. Enterprise im direkten Vergleich
  • Eine Customer Case Study aus der Praxis
  • Ein Kahoot-Quiz mit Preis
  • Zum Abschluss ein Apéro mit Zeit für Fragen und Austausch

Die Plätze sind auf 40 Personen begrenzt.

Jetzt für den Workshop anmelden.

Markus Speth

Marketing, Communications, People

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
AppCat Tech

AppCat Update – StackGres End of Life Ankündigung

10. Juni 2026

AppCat v4.188.0 ist ein kleineres Release mit technischen Verbesserungen im Hintergrund – aber es enthält eine wichtige Ankündigung: VSHN PostgreSQL with StackGres erreicht am 31. August 2026 das End of Life.

VSHN PostgreSQL with StackGres – End of Life am 31. August 2026

VSHN PostgreSQL with StackGres erreicht am 31. August 2026 das End of Life. Alle neuen PostgreSQL-Instanzen verwenden bereits CloudNativePG – das im letzten AppCat-Release zum Standard wurde. Wer noch nicht migriert hat, sollte jetzt damit beginnen.

Es gibt zwei Möglichkeiten:

Bei Fragen stehen wir gerne zur Verfügung.

Das grössere Bild: ein reifes souveränes Ökosystem

Die Ablösung von StackGres ist Teil der breiteren Weiterentwicklung von AppCat als operativer Grundlage des souveränen Managed-Services-Ökosystems von VSHN.

Wer verstehen möchte, wie AppCat ins grosse Bild passt – von Framework 0.1 im Jahr 2021 bis hin zu Servala und AppSlap 2.0 heute – findet die Antworten in unserem aktuellen Beitrag: Eine Tour durch unser digital souveränes Ökosystem.

Kontinuierliche Verbesserungen im Hintergrund

Wie bei den meisten AppCat-Releases enthält auch v4.188.0 eine Reihe kleinerer technischer Verbesserungen, die die Plattform stabil und wartbar halten. Das sind die Änderungen, die keine Schlagzeilen machen – aber genau dafür sorgen, dass produktive Workloads zuverlässig laufen.

👉 Vollständiges Changelog lesen: AppCat Changelog 2026-06-02

👉 Mehr erfahren über VSHN AppCat

Liene Luksika

Product Manager

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
AppCat Tech

VSHN AppCat Update – CloudNativePG wird neuer Standard für PostgreSQL

28. Mai 2026

Das neueste VSHN AppCat Release v4.187.0 setzt den Wandel der Plattform hin zu einem Kubernetes-nativeren PostgreSQL-Erlebnis fort.

Mit diesem Release wird CloudNativePG offiziell zur Standard-PostgreSQL-Implementierung für alle neu erstellten PostgreSQL-Instanzen in AppCat. Bestehende Instanzen bleiben unverändert, neue Deployments verwenden jedoch künftig automatisch das CloudNativePG-basierte Setup.

Dies markiert einen weiteren wichtigen Meilenstein in der Reifung des PostgreSQL-Betriebs innerhalb von AppCat.

CloudNativePG ist nun Standard für PostgreSQL

CloudNativePG hat sich über die letzten Releases stetig innerhalb von AppCat weiterentwickelt und den Punkt erreicht, an dem es zur Standardwahl für neue PostgreSQL-Deployments wird.

Für Nutzerinnen und Nutzer bedeutet das:

  • Neue PostgreSQL-Instanzen verwenden automatisch CloudNativePG
  • Verbesserter Kubernetes-nativer Betrieb
  • Bessere langfristige Wartbarkeit
  • Fortlaufende Investitionen in das CloudNativePG-Ökosystem

Teams, die bereits ältere PostgreSQL-Implementierungen betreiben, können diese weiterhin normal nutzen, während die Migrationsplanung im eigenen Zeitrahmen erfolgen kann.

Verbesserungen über die gesamte Plattform hinweg

Neben dem PostgreSQL-Wandel enthält das Release auch mehrere betriebliche Verbesserungen und Fehlerbehebungen über die gesamte Plattform hinweg.

Bessere Handhabung der Garage-CRD-Versionen

Das Release verbessert wie Garage-CRD-Versionen intern gehandhabt werden. Dies trägt zu einem vorhersehbareren Verhalten bei Upgrades und Plattformwartung bei.

Verbesserte Handhabung des topologyKey für CloudNativePG

Die Topologie-Handhabung für CloudNativePG-Deployments wurde verfeinert, um die Scheduling-Konsistenz in Kubernetes-Clustern zu verbessern.

Bessere Warnungen für enableSSHInRelease

Die Handhabung von enableSSHInRelease bietet nun ein verbessertes Warnverhalten und hilft Nutzerinnen und Nutzern, mögliche Auswirkungen bei Deployments und Wartungsarbeiten besser zu verstehen.

Kontinuierliche Verbesserungen hinter den Kulissen

Viele AppCat Releases konzentrieren sich auf operative Exzellenz statt auf auffällige, nach aussen sichtbare Features – und genau das hält Produktionsplattformen über die Zeit zuverlässig. Indem AppCat CloudNativePG zur Standard-PostgreSQL-Grundlage macht und das Plattformverhalten kontinuierlich verfeinert, bewegt es sich weiter in Richtung einer stabileren, Kubernetes-nativen und zukunftssicheren Applikationsplattform.

👉 Den vollständigen Changelog lesen: AppCat Changelog 2026-05-19

👉 Mehr über VSHN AppCat erfahren

Liene Luksika

Product Manager

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Allgemein Servala Tech

VSHN AppCat Update – Servala Grundlagen, Garage Monitoring und OpenBao Sneak Peek

11. Mai 2026

Mit AppCat v4.186.0 ist im Hintergrund einiges passiert. Dieses Release dreht sich weniger um sichtbare UI-Änderungen und vielmehr um die Grundlage für das, was als Nächstes kommt: tiefere Servala-Integration, verbesserte Storage-Operations und neue Services am Horizont.

Von zusätzlichen Networking- und Storage-Funktionen für Servala über die Vorbereitung von Migrationen von MinIO zu Garage bis hin zur stillen Einführung erster OpenBao-Unterstützung – dieses Release baut die nächste Plattformschicht.

👉 Vollständige Release Details: Changelog 2026-05-05

Servala Enablement

Ein grosser Teil dieses Releases fokussiert sich auf den Ausbau der technischen Grundlage hinter Servala – Sovereign App Store.

Mehrere neue Funktionen wurden in AppCat ergänzt, um zukünftige Services und Integrationen zu unterstützen, darunter Generic Object Buckets, HTTPRoute, TCPRoute sowie TCP Gateway Support.

Auch wenn viele dieser Verbesserungen aktuell für Endnutzer noch unsichtbar bleiben, sind sie wichtige Bausteine für flexiblere und produktionsreife Services über Servala.

Das ist eines dieser Releases, dessen Wirkung erst mit der Zeit sichtbar wird.

👉 Mehr über Servala: Servala – Sovereign App Store

Garage Monitoring und kommende Migrationen

Wir haben begonnen, Metrics und Monitoring-Daten für Garage Object Storage zu sammeln.

Dadurch verbessern wir Alerting, operative Transparenz und die Zuverlässigkeit unserer Managed Object Storage Services.

Gleichzeitig starten wir offiziell den Migrationspfad von MinIO zu Garage.

Garage entwickelt sich zur zukünftigen Standardlösung für Object Storage Services innerhalb von AppCat und Servala. Bestehende Nutzer werden bald von uns hören, damit wir Migrationen gemeinsam planen können.

Das Ziel ist einfach: bessere Operations, höhere Skalierbarkeit und eine langfristig bessere Experience.

👉 Mehr über Garage: Garage by VSHN

OpenBao kommt

Eine kleine Zeile im Changelog deutet möglicherweise bereits auf eine der spannendsten Ergänzungen der letzten Monate hin: OpenBao.

Der Service ist aktuell noch nicht öffentlich verfügbar, aber die ersten Bausteine landen bereits in AppCat.

OpenBao ist ein Open Source Fork von HashiCorp Vault mit Fokus auf offene Governance und Community-getriebene Entwicklung. Für Organisationen, die sich mit sicherem Secret Management, Verschlüsselung und Identity Workflows ohne Vendor Lock-in beschäftigen, ist das ein sehr spannendes Thema.

Wir freuen uns sehr auf die Möglichkeiten hier – mehr Informationen folgen bald.

👉 Mehr über OpenBao: OpenBao by VSHN

PostgreSQL mit CloudNativePG ist jetzt produktionsreif

Ein weiterer wichtiger Meilenstein: PostgreSQL by VSHN mit CloudNativePG ist jetzt offiziell produktionsreif.

In den letzten Monaten hat sich CloudNativePG von einer vielversprechenden neuen PostgreSQL-Grundlage zur zukünftigen Standardrichtung für PostgreSQL Services in AppCat entwickelt.

Mit Self Service Restore, operativer Reife und vorhandenen Migrationstools empfehlen wir Nutzern, Migrationen auf CloudNativePG-basierte PostgreSQL-Instanzen zu planen.

Ihr könnt entweder selbst der Migrationsanleitung folgen oder euch bei der Migration von uns unterstützen lassen.

👉 Mehr über PostgreSQL mit CloudNativePG: PostgreSQL by VSHN mit CloudNativePG

👉 Migrationsanleitung: Migration einer PostgreSQL-Instanz zu einer anderen PostgreSQL-Instanz

Auch stille Releases sind wichtig

Nicht jedes AppCat Release dreht sich um grosse neue Features. Oft passiert die wichtigste Arbeit in den Plattform-Grundlagen: Networking, Observability, Migrationen, Zuverlässigkeit und die Vorbereitung der nächsten Service-Generation.

AppCat v4.186.0 ist genau so ein Release.

Und auch wenn einige Verbesserungen heute noch unsichtbar bleiben, prägen sie bereits jetzt, was Nutzer morgen bauen und betreiben können.

👉 Mehr über VSHN AppCat: Application Catalog by VSHN AG

Liene Luksika

Product Manager

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
AppCat Tech

VSHN AppCat Update – CloudNativePG PostgreSQL ist jetzt vollständig in AppCat verfügbar

28. Apr. 2026

Mit AppCat v4.185.0 ist PostgreSQL auf Basis von CloudNativePG jetzt vollständig in AppCat verfügbar. Was als neue Grundlage für den Betrieb von PostgreSQL auf Kubernetes begonnen hat, ist damit funktional komplett umgesetzt.

👉 Vollständige Release-Details.

👉 Mehr über PostgreSQL mit CloudNativePG erfahren.

Ein wichtiger Schritt auf dem Weg dorthin war das Schliessen der letzten verbleibenden Lücke: Self Service Restore.

Self Service Restore vervollständigt den Funktionsumfang

Self Service Restore für PostgreSQL war das letzte fehlende Element. Mit dieser Funktion ist der auf CloudNativePG basierende PostgreSQL-Service in AppCat nun vollständig verfügbar.

Du kannst deine PostgreSQL-Instanzen jetzt selbst wiederherstellen und den Prozess mithilfe des bereitgestellten Restore-Guides testen.

👉 Mehr zum Restore-Guide.

Jetzt ist auch ein guter Zeitpunkt, um deine Migration von StackGres zu CloudNativePG zu planen.

👉 Kontaktiere uns für die Migrationsplanung.

CloudNativePG als Standard für Nextcloud

Im Zuge dieses Releases wird CloudNativePG PostgreSQL zur Standarddatenbank für neue Nextcloud-Deployments.

Diese Änderung betrifft nur neu bereitgestellte Instanzen. Bestehende Setups bleiben unverändert.

Beim Erstellen einer neuen Nextcloud-Instanz kannst du weiterhin eine bereits bestehende PostgreSQL-Datenbank anbinden. Wenn du eine Migration planst, erhältst du bei Bedarf Unterstützung.

👉 Sprich mit uns über deine Migration.

Aufräumen im Object Storage mit dem Garage Operator

Dieses Release adressiert auch ein praktisches Problem im Umgang mit Object Storage.

Bisher wurden Buckets, die zur Löschung markiert waren, nicht entfernt, wenn sie noch Daten enthielten. Dadurch haben diese weiterhin Speicherplatz belegt.

Mit der Einführung von Garage Cleanup werden nun alle Objekte innerhalb eines Buckets automatisch gelöscht, sobald dieser in den Löschstatus wechselt. Dadurch kann der Bucket vollständig entfernt werden und es bleibt kein unnötig belegter Speicher zurück.

Zusammenfassung

Mit der Einführung von Self Service Restore ist PostgreSQL mit CloudNativePG in AppCat jetzt vollständig verfügbar. Gleichzeitig wird es zur Standardwahl für neue Nextcloud-Deployments, während Verbesserungen wie automatisches Bucket Cleanup operative Randfälle sauber lösen.

👉 Mehr über VSHN AppCat erfahren.

Liene Luksika

Product Manager

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
AppCat Tech

VSHN AppCat Update – Grosse PostgreSQL Upgrades und mehr Kontrolle über Kosten

16. Apr. 2026

Der Betrieb von zustandsbehafteten Services auf Kubernetes gehört seit jeher zu den komplexeren Herausforderungen – insbesondere wenn es um Datenbanken wie PostgreSQL geht.

Mit dem neuesten VSHN AppCat Release führen wir einen wichtigen Meilenstein für unser PostgreSQL-Angebot auf Basis von CloudNativePG ein, zusammen mit Verbesserungen, die dir mehr Kontrolle darüber geben, wie deine Services verwaltet und betrieben werden.

Dieses Release konzentriert sich auf drei zentrale Bereiche: Datenbank Lifecycle Management, Nutzerkontrolle und Kostenoptimierung.

Was ist VSHN AppCat?

VSHN AppCat ist der VSHN Application Catalog – eine kuratierte Sammlung produktionsreifer Anwendungen, die mit minimalem Aufwand auf Kubernetes bereitgestellt und betrieben werden können.

Anstatt komplexe Software-Stacks manuell zu installieren und zu betreiben, ermöglicht AppCat Teams, Services wie Datenbanken, Identity Provider oder Kollaborationsplattformen als vollständig gemanagte Anwendungen zu nutzen.

AppCat umfasst:

  • Automatisierte Betriebs- und Lifecycle-Prozesse
  • Integriertes Monitoring, Backups und Wartung
  • Konsistente Deployments über verschiedene Kubernetes-Umgebungen hinweg

Dadurch können sich Teams auf ihre Anwendungen konzentrieren, während VSHN die operative Komplexität im Hintergrund übernimmt.

👉 Erfahre mehr über VSHN AppCat

Grosse PostgreSQL Versions-Upgrades mit CloudNativePG

Dieses Release bringt eine wichtige neue Funktion für PostgreSQL in AppCat: Major-Version-Upgrades mit CloudNativePG.

Zum ersten Mal können Nutzer die Hauptversion ihrer PostgreSQL-Instanzen direkt innerhalb der AppCat-Umgebung upgraden.

Major-Version-Upgrades gehören zu den sensibelsten Operationen im Datenbank Lifecycle Management. Diese Funktion als Teil eines Managed Services bereitzustellen, ist ein wichtiger Schritt für nachhaltige und langfristig stabile PostgreSQL-Workloads auf Kubernetes.

👉 Erfahre mehr über PostgreSQL Upgrades

PostgreSQL User Management für CloudNativePG

Zusätzlich haben wir User-Management-Funktionen für PostgreSQL in unserem CloudNativePG-basierten Angebot eingeführt.

Während PostgreSQL selbst schon immer Benutzerverwaltung unterstützt hat, ist diese Funktionalität nun direkt in das von AppCat gemanagte CloudNativePG Setup integriert.

Das gibt dir mehr direkte Kontrolle über Datenbankzugriffe und Rollen innerhalb deiner gemanagten PostgreSQL-Instanzen.

👉 Erfahre mehr über PostgreSQL User Management

Bring Your Own Bucket für Backups

Eine weitere wichtige Neuerung in diesem Release ist die “Bring Your Own Bucket”-Funktion.

Du kannst jetzt deinen eigenen, nicht von AppCat verwalteten Object Storage Bucket für Backups verwenden, anstatt automatisch bereitgestellten Storage zu nutzen.

Wenn ein Bucket angegeben wird, verwendet AppCat die bereitgestellten Zugangsdaten und überspringt die interne Bucket-Provisionierung vollständig.

Das ist besonders interessant für Organisationen, die:

  • Bereits eigene Storage-Infrastruktur betreiben
  • Storage über mehrere Services hinweg konsolidieren möchten
  • Backup-Kosten optimieren wollen

👉 Erfahre mehr zur Backup-Konfiguration

Kontinuierliche Weiterentwicklung der Plattform

Der Betrieb von Datenbanken und zustandsbehafteten Services auf Kubernetes entwickelt sich stetig weiter – und dieses Release ist ein wichtiger Schritt nach vorne.

Mit Major-Version-Upgrades, integriertem User Management und mehr Kontrolle über Backup-Infrastruktur erweitert AppCat kontinuierlich die Möglichkeiten von Managed Services auf Kubernetes.

Wie immer bleibt das Ziel gleich: komplexe Operationen einfacher, sicherer und planbarer für Teams zu machen, die produktive Workloads betreiben.

👉 Erfahre mehr über VSHN AppCat

👉 VSHN AppCat Changelog

Liene Luksika

Product Manager

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Allgemein Tech

Espejote: Eine GitOps-Reise

14. Apr. 2026

Espejote (grosser Spiegel auf Spanisch) verwaltet beliebige Ressourcen in einem Kubernetes-Cluster. Von Grund auf entwickelt, um Server-Side Apply und Jsonnet-Templating optimal zu nutzen.

Wir betreiben bei VSHN eine grosse Anzahl von Kubernetes-Clustern für unsere Kunden und wir versuchen, so viel wie möglich zu automatisieren, um unsere Betriebsabläufe effizient und nachhaltig zu gestalten. Wir nutzen GitOps-Prinzipien, aber manchmal muss externer Zustand mit dem in Git definierten Zielzustand zusammengeführt werden. Diese GitOps-Reise führte uns von Ansible-Playbooks, die direkt YAML anwenden, über verschiedene Operatoren, hin zu Bash-„Reconcilern“ und schliesslich zu Espejote, unserem neuen GitOps-Operator.

Kapitel 1: Die Ansible-Ära und erste Operator-Versuche

Am Anfang nutzten wir Ansible-Playbooks und eigene Rollen, um unsere OpenShift 3 Kubernetes-Cluster zu verwalten. Wir hatten eine Sammlung von YAML-Dateien, die den gewünschten Zustand unserer Cluster definierten und führten Ansible-Playbooks aus, um diese auf die Cluster anzuwenden. Das funktionierte, war aber nicht besonders effizient. Wir mussten die Playbooks manuell ausführen, und wenn wir das vergassen, drifteten die Cluster vom gewünschten Zustand ab.

Die Sammlung von Rollen erhielt den Spitznamen „mungg“, das schweizerdeutsche Wort für „Murmeltier“. Niemand weiss genau warum, aber der Name blieb.

Wir begannen gerade erst damit, Operatoren zu entwickeln und entwickelten espejo, um Ressourcen schnell zwischen Namespaces zu synchronisieren. Es war die sehr frühe Phase unserer Operator-Reise.

Kapitel 2: Das Meer der Operatoren und der Tränen

Um das Problem der manuellen Eingriffe zu lösen (und weil wir auf OpenShift 4 migrierten, wo das Installationsverfahren kein Ansible mehr nutzt), begannen wir, uns mit Kubernetes-Operatoren zu beschäftigen. So schwer kann es doch nicht sein, ein Kubernetes-Manifest zu patchen. Oder? Falsch.
Einige Operatoren waren fehlerhaft, andere nicht flexibel genug, manche gerieten zufällig in Reconcile-Loops und die meisten verbrauchten zu viele Ressourcen. Einige brachten sogar unsere API-Server zum Absturz. Wir begannen mit resource-locker-operator, migrierten zu patch-operator, verursachten Ausfälle mit Kyverno und testeten alle Policy-Engines, die wir finden konnten. Kubewarden war die einzige, die uns wirklich gefiel, aber die Cluster-Context-API war noch nicht flexibel genug für unsere Anwendungsfälle.

Espejo war ein guter Anfang, aber wir hatten noch nicht die Erfahrung, gut designte Operatoren zu bauen. Das zeigte sich. Jedes Event löste eine vollständige Reconciliation aller Ressourcen aus, wodurch die Synchronisation in grösseren Clustern drastisch langsamer wurde. Uns fehlte viel Flexibilität.

Kapitel 3: Verzweifelte Suche nach stabilen Landungen

Wir hatten genug von den ständigen Bugs und Breaking Changes in Kyverno und patch-operator wurde kaum gepflegt. Espejo war an seine Grenzen gestossen.

Verzweifelte Zeiten erfordern verzweifelte Massnahmen, also begannen wir, eine Mischung aus Bash-„Reconcilern“ – Hacks mit Cronjobs, kleinen eigenen Controllern und Vorverarbeitung von Ressourcen in Project Syn.

Wir nutzten zunehmend Jsonnet. Project Syn-Komponenten verwenden hauptsächlich Jsonnet. Wir setzen Jsonnet für unseren cloudscale machine-api provider, für unsere SSO-Lösung und viele weitere Projekte ein.

Ein wachsendes Problem waren unsere stark angepassten OpenShift-Alerting-Regeln. Wir kuratieren Upstream-Regeln und aktivieren nur diejenigen, die wir benötigen. Einige sind stark modifiziert. Mit jeder OpenShift-Version werden die Upstream-Definitionen verschoben und sind teilweise nur noch in Go-Code eingebettet verfügbar. Wir brauchten etwas, das bereits im Cluster deployte Regeln patchen kann, da dies die einzige stabile Schnittstelle war.

Kapitel 4: Espejote, der neue GitOps-Operator

Mit wachsender Operator-Erfahrung und unserer Begeisterung für Jsonnet entschieden wir uns, unseren eigenen Operator zu bauen – einen, der alles kann. Wir wollten etwas Flexibles, Effizientes und Einfaches. Etwas, das all unsere Anwendungsfälle abdeckt, vom Synchronisieren von Ressourcen zwischen Namespaces bis hin zum Patchen von OpenShift-Alerting-Regeln.

Espejote ist das Ergebnis dieser Reise. Es kombiniert Cluster-Zustand mit GitOps-Prinzipien und nutzt Jsonnet zur Definition des gewünschten Zustands. Es cached den Cluster-Zustand effizient, und die Reconcile-Trigger-Logik ist explizit definiert. Sinnvolle controller-runtime Rate Limits kommen zum Einsatz. Jsonnet bietet enorme Flexibilität, und natives Server-Side Apply macht das Hinzufügen und Entfernen von Schlüsseln einfach. Jeder Espejote „Resource Manager“ – also der dynamische Controller pro Konfigurationseinheit – nutzt eine eigene ServiceAccount für Least Privilege.

Espejote ist genau der Operator, den wir immer wollten und wir freuen uns, ihn mit der Welt zu teilen.

Was ist Espejote?

Espejote ist ein Kubernetes-Operator, mit dem du beliebige Ressourcen in einem Kubernetes-Cluster verwalten kannst. Er kombiniert GitOps-Prinzipien mit dem Zustand im Cluster.

Warum Espejote?

Es gibt viele ähnliche Tools (und Policy-Engines), aber Espejote hebt sich durch drei zentrale Säulen ab:

1. Powered by Jsonnet

Espejote nutzt Jsonnet als Templating-Engine. Im Gegensatz zu YAML kombiniert mit Go-Templates behandelt Jsonnet Konfigurationen als Datenstruktur. Es versteht Objekte, Arrays und Strings. Es kann nicht versehentlich fehlerhaftes YAML erzeugen, da Jsonnet sicherstellt, dass die interne Datenstruktur gültig ist, bevor überhaupt eine Datei exportiert wird.

2. Native Server-Side Apply

Espejote wurde von Grund auf für Server-Side Apply (SSA) entwickelt. Das bedeutet, dass Espejote gut mit anderen Controllern und Operatoren zusammenarbeitet. Es kann einzelne Annotationen oder komplette Ressourcen verwalten – SSA sorgt dafür, dass Änderungen sauber zusammengeführt werden, ohne andere Tools zu überschreiben.

3. Zuverlässigkeit

Zuverlässigkeit ist kein nachträglicher Gedanke. Espejote entstand aus der Frustration über Operatoren, die in Endlosschleifen geraten oder Cluster zum Absturz bringen. Es bietet:

  • Sinnvolle Rate Limits und Backoff-Strategien.
  • Jede Konfigurationseinheit („Resource Manager“) läuft als eigener, dynamisch erzeugter Controller, sodass fehlerhafte Einheiten andere nicht beeinflussen.
  • Least Privilege: Jeder Resource Manager nutzt eine eigene ServiceAccount.
  • Volle Kontrolle: Keine impliziten Watches oder „magischen“ Trigger – du bestimmst genau, was wann reconciled wird.

Praxisbeispiele

Was kannst du konkret mit Espejote machen? Hier einige Beispiele aus dem produktiven Einsatz bei VSHN:

  • Secret-Synchronisation: Automatisches Replizieren von Secrets (z.B. Image Pull Secrets oder Zertifikate) über mehrere Namespaces hinweg.
  • Autoscaler-Patching: Anpassung des OpenShift Cluster Autoscalers über Admission Webhooks.
  • Alerting-Regel-Management: Kuratieren und Patchen von OpenShift-Alerting-Regeln über verschiedene Cluster-Versionen hinweg.

Die Zukunft: WASM und mehr

Die Roadmap umfasst einen kro-ähnlichen API-Builder zur einfachen Erstellung eigener Ressourcen sowie Unterstützung für WebAssembly-Plugins. Damit können Entwickler eigene Logik in nahezu jeder Sprache schreiben und sicher im Espejote-Controller ausführen.

Erste Schritte

Beispiel

Dieses Beispiel ManagedResource patcht die RedHat OperatorHub-Konfiguration, um alle Standardquellen zu deaktivieren. Es zeigt den einfachsten Anwendungsfall: ein statisches Manifest bedingungslos patchen. Komplexere Anwendungsfälle findest du im Abschnitt „Erste Schritte“.

apiVersion: espejote.io/v1alpha1
kind: ManagedResource
metadata:
  annotations:
  name: disable-default-sources
  namespace: openshift-marketplace
spec:
  serviceAccountRef:
    name: disable-default-sources
  triggers:
    - name: operatorhub
      watchResource:
        apiVersion: config.openshift.io/v1
        kind: OperatorHub
        name: cluster
  template: |-
    {
        "apiVersion": "config.openshift.io/v1",
        "kind": "OperatorHub",
        "metadata": {
            "name": "cluster"
        },
        "spec": {
            "disableAllDefaultSources": true
        }
    }

Sebastian Widmer

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
AppCat Tech

VSHN AppCat Update – Mehr Flexibilität für PostgreSQL und höhere Betriebssicherheit auf der Plattform

13. Apr. 2026

Anwendungen auf Kubernetes zu betreiben bedeutet nicht nur, sie zu deployen – sondern sie langfristig zuverlässig zu betreiben. Dazu gehört das Management von Datenbanken, der Umgang mit Authentifizierung und sicherzustellen, dass sich Services ohne riskante Änderungen weiterentwickeln können.

Mit dem neuesten Release von VSHN AppCat führen wir Verbesserungen ein, die sich auf mehr Flexibilität bei Datenbanken, bessere Integrationsmöglichkeiten und sicherere Betriebsprozesse auf der gesamten Plattform konzentrieren.

Wie immer passieren viele dieser Verbesserungen im Hintergrund – sie wirken sich aber direkt darauf aus, wie Teams ihre Services betreiben und nutzen.

Was ist VSHN AppCat?

VSHN AppCat ist der VSHN Application Catalog – eine kuratierte Sammlung produktionsreifer Anwendungen, die sich mit minimalem Aufwand auf Kubernetes deployen und betreiben lassen.

Anstatt komplexe Software-Stacks manuell zu installieren und zu betreiben, ermöglicht AppCat Teams, Services wie Datenbanken, Identity Provider oder Kollaborationsplattformen als vollständig gemanagte Anwendungen zu nutzen.

Das umfasst:

  • Automatisierten Betrieb und Lifecycle-Management
  • Integriertes Monitoring, Backup und Wartung
  • Konsistente Deployments über verschiedene Kubernetes-Umgebungen hinweg

So können sich Teams auf ihre Anwendungen konzentrieren, während VSHN den Betrieb der zugrunde liegenden Services übernimmt.

👉 Mehr über VSHN AppCat erfahren:
Application Catalog – VSHN AG

Mehr Flexibilität mit PostgreSQL Extensions

Eine der zentralen Verbesserungen in diesem Release betrifft PostgreSQL auf Basis von CloudNativePG.

Wir haben zusätzliche Konfigurationsmöglichkeiten für PostgreSQL Extensions eingeführt. Damit kannst du extensionspezifische Libraries aktivieren und konfigurieren, wenn diese benötigt werden. Das schafft mehr Flexibilität für Teams, die auf erweiterte PostgreSQL-Funktionalitäten angewiesen sind.

Zusätzlich wurde VACUUM als Teil der geplanten Wartung integriert. Regelmässige VACUUM-Operationen sind entscheidend, um Performance und Speichereffizienz von Datenbanken langfristig sicherzustellen.

Diese Verbesserungen geben dir mehr Kontrolle darüber, wie sich deine PostgreSQL-Instanzen verhalten – ohne die Vorteile eines gemanagten Services zu verlieren.

Verbesserte Integration mit Forgejo

Dieses Release verbessert auch die Integrationsmöglichkeiten für Entwicklerplattformen.

Wir haben die notwendigen Parameter zur Konfiguration von OAuth2-Clients in Forgejo verfügbar gemacht. Damit kannst du Forgejo-basierte Services einfacher mit bestehenden Authentifizierungs- und Identity-Systemen verbinden.

Das ist besonders hilfreich für Teams, die ihre Entwicklungsprozesse mit zentralen Identity-Management-Lösungen integrieren möchten.

Sicherer Betrieb für Nextcloud

Zuverlässiger Betrieb bedeutet auch, unsichere Konfigurationen zu verhindern.

Mit diesem Release haben wir eine Schutzmassnahme für Nextcloud eingeführt: Downgrades zwischen Major-Versionen sind jetzt explizit blockiert.

Da Nextcloud selbst keine Major-Downgrades unterstützt, könnten solche Versuche zu fehlerhaften Instanzen oder Dateninkonsistenzen führen. Durch diese Einschränkung stellt AppCat sicher, dass Upgrades sicher und vorhersehbar bleiben.

Für dich bedeutet das: bleib auf dem aktuellen Stand und folge den vorgesehenen Upgrade-Pfaden bei Versionswechseln.

👉 Mehr über Nextcloud erfahren:
Nextcloud by VSHN – VSHN AG

Kontinuierliche Plattformverbesserungen

Anwendungen auf Kubernetes zuverlässig zu betreiben ist ein kontinuierlicher Prozess.

Dieses AppCat-Release konzentriert sich darauf, mehr Flexibilität dort zu schaffen, wo sie gebraucht wird – und Sicherheit dort durchzusetzen, wo sie entscheidend ist. Von besser konfigurierbaren PostgreSQL Extensions bis hin zu sicheren Upgrade-Pfaden und verbesserten Integrationen helfen diese Änderungen dabei, Services stabil und zuverlässig zu betreiben.

VSHN AppCat entwickelt sich kontinuierlich weiter, um den Betrieb von produktiven Workloads auf Kubernetes einfacher, zuverlässiger und konsistenter zu machen.

👉 Mehr über VSHN AppCat erfahren:
Application Catalog – VSHN AG

👉 VSHN AppCat Changelog:
Changelog 2026-03-24

Liene Luksika

Product Manager

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
AppCat Tech

VSHN AppCat Update – Verbesserte Zuverlässigkeit, Betrieb und Entwicklerplattformen

16. März 2026

Moderne Anwendungen auf Kubernetes zu betreiben ist leistungsfähig – bringt aber auch Komplexität mit sich. Datenbanken, Identity-Services, Kollaborationsplattformen und Entwickler-Tools benötigen sorgfältiges Lifecycle-Management, Upgrades, Monitoring und Sicherheitskonfigurationen.
Genau hier kommt VSHN AppCat ins Spiel.
Mit der neuesten AppCat-Version führen wir mehrere Verbesserungen ein, die die Zuverlässigkeit und operative Konsistenz der auf der Plattform betriebenen Anwendungen weiter stärken.
Viele der Änderungen passieren im Hintergrund – sie verbessern jedoch direkt den täglichen Betrieb für Teams, die Produktions-Workloads auf Kubernetes betreiben.

Was ist VSHN AppCat?

VSHN AppCat ist der VSHN Application Catalog – eine kuratierte Sammlung produktionsreifer Anwendungen, die sich mit minimalem Aufwand auf Kubernetes deployen und betreiben lassen.
Anstatt komplexe Software-Stacks manuell zu installieren und zu betreiben, können Teams mit AppCat weit verbreitete Services wie Datenbanken, Identity Provider, Kollaborationsplattformen oder Entwickler-Tools als vollständig gemanagte Anwendungen deployen.
AppCat bietet:

  • Produktionsreife Kubernetes Deployments
  • Automatisierten Betrieb und Lifecycle-Management
  • Integrierte Monitoring-, Backup- und Wartungsprozesse
  • Konsistente Deployments über verschiedene Kubernetes-Umgebungen hinweg
    So können sich Plattformteams und Entwickler auf das Entwickeln und Betreiben ihrer Anwendungen konzentrieren, während VSHN die operative Komplexität im Hintergrund übernimmt.

👉 Mehr über den VSHN Application Catalog erfahren

Smarteres Alerting für Endnutzer

Zuverlässiger Betrieb erfordert gutes Alerting – aber Alerts sollten handlungsrelevant sein und nicht überwältigend.
In diesem Release haben wir das Endnutzer-Alerting verbessert, um unnötige Alert-Flut zu reduzieren und gleichzeitig wichtige Signale sichtbar zu halten.
Zum Beispiel wurden Alerts für Speicherplatzprobleme bisher jede Minute ausgelöst. Technisch korrekt, aber oft unnötig laut im Alltag.
Die neue Konfiguration erhöht das Intervall auf 15 Minuten. Dadurch wird Alert-Flapping reduziert, während Nutzer weiterhin ausreichend Zeit haben, auf potenzielle Probleme zu reagieren.
Wenn du Alerting für deine AppCat-Instanzen noch nicht konfiguriert hast, empfehlen wir dringend, es zu aktivieren.

Verbesserte PostgreSQL-Zuverlässigkeit

Mehrere Verbesserungen in diesem Release zielen darauf ab, den Betrieb von PostgreSQL robuster zu machen.
Ein Problem konnte auftreten, wenn mehrere Datenbanken gleichzeitig erstellt wurden. In seltenen Fällen führte dies zu Race Conditions bei der Benutzerverwaltung.
Durch Anpassungen im Bootstrap-Prozess der Datenbank und die Verwendung einer geeigneteren Template-Datenbank wurde dieses Problem behoben.
Solche Verbesserungen sind für Nutzer oft unsichtbar – sie sind jedoch entscheidend, um Plattformbetrieb zuverlässig und skalierbar zu machen.

CloudNativePG für Keycloak

Wir haben auch das PostgreSQL-Backend verbessert, das für den Keycloak Identity Service in AppCat verwendet wird.
Neue Keycloak-Instanzen nutzen künftig CloudNativePG, einen speziell für cloud-native Umgebungen entwickelten PostgreSQL-Operator für Kubernetes.
Bestehende Keycloak-Installationen bleiben unverändert und funktionieren weiterhin wie bisher. Das neue Backend wird automatisch verwendet, wenn neue Keycloak-Instanzen erstellt werden.

👉 Mehr über Keycloak erfahren

Updates für Entwickler-Kollaborationsplattformen

Dieses Release enthält auch Updates für Forgejo und Codey, sodass diese Services weiterhin auf unterstützten Upstream-Versionen laufen.

Was ist Codey?

Codey ist VSHNs europäische Code-Collaboration-Plattform, die auf dem Open-Source-Projekt Forgejo basiert.
Anstatt eine eigene Git-Plattform zu betreiben, können Teams vollständig gemanagte Forgejo-Instanzen nutzen, die von VSHN betrieben werden – inklusive Monitoring, Backups und Lifecycle-Management.
Codey bietet Funktionen wie:

  • Git Repository Hosting
  • Pull Requests und Code Reviews
  • CI/CD kompatibel mit GitHub Actions Workflows
  • Package- und Container-Registries
  • Integrierte Projektmanagement-Tools
    Codey läuft auf europäischer Cloud-Infrastruktur, unter anderem in der Schweiz, wodurch Organisationen Kontrolle über ihre Entwicklungsdaten behalten und gleichzeitig von einem vollständig gemanagten Service profitieren.

👉 Mehr über Codey erfahren

Verbesserte Sicherheit für Nextcloud

Dieses Release enthält ausserdem Verbesserungen an der Sicherheitskonfiguration des Nextcloud Cronjobs.
Zuvor konnte der Job in einigen Kubernetes-Umgebungen mit falschen Benutzerrechten ausgeführt werden.
Die neue Konfiguration stellt sicher, dass der Job mit dem korrekten Security Context läuft und verbessert damit die Kompatibilität mit Kubernetes-Plattformen wie Vanilla Kubernetes und OpenShift.

👉 Mehr über Nextcloud erfahren

Konsistentere Wartungsplanung

Für Services mit PostgreSQL-Abhängigkeiten – etwa Keycloak und Nextcloud – haben wir Edge Cases behoben, bei denen Wartungsfenster leicht von der konfigurierten Zeit abweichen konnten.
Wartungsoperationen werden nun konsistenter über abhängige Services hinweg durchgeführt.

Kontinuierliche Plattformverbesserungen

Anwendungen zuverlässig auf Kubernetes zu betreiben erfordert kontinuierliche Verbesserungen bei Automatisierung, Observability und operativen Prozessen.
Dieses AppCat-Release konzentriert sich genau darauf: mehr Zuverlässigkeit, Konsistenz und bessere Betriebserfahrung auf der Plattform.
Viele Verbesserungen passieren im Hintergrund – sie helfen Teams jedoch dabei, kritische Services sicherer und mit weniger Betriebsaufwand zu betreiben.
Wenn du nach einer einfacheren Möglichkeit suchst, produktionsreife Services auf Kubernetes zu betreiben, bietet VSHN AppCat eine bewährte Grundlage.

👉 VSHN AppCat Changelog

Liene Luksika

Product Manager

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Allgemein Event Tech

Cloud Native Computing Switzerland Meetup – März 2026 Recap

10. März 2026

Am 10. März traf sich die Cloud Native Computing Switzerland Meetup Community erneut im VSHN Tower in Zürich zu einem Nachmittag voller technischer Talks, Diskussionen und Austausch innerhalb der Cloud-Native-Community.

Mit inzwischen 3.000 Mitgliedern gehört die Gruppe zu den aktivsten Cloud-Native-Communities in der Schweiz und bringt regelmässig Platform Engineers, DevOps Engineers, Architektinnen und Architekten sowie Open-Source-Enthusiasten zusammen.

Die März-Ausgabe bot vier Talks rund um Themen wie Kubernetes Security, Plattform-Engineering und MLOps.

Begrüssung und Community Updates

Aarno Aukia und Patrick Mathers – VSHN

Das Meetup begann mit einer kurzen Begrüssung und Community-Updates durch die Organisatoren. Die CNC Switzerland Meetups folgen dabei einigen klaren Prinzipien:

  • Alle Vorträge sind technisch und Open-Source-orientiert
  • Keine Produkt- oder Sales-Pitches
  • Die Talks finden auf Englisch statt
  • Speaker aus unterrepräsentierten Gruppen sind ausdrücklich willkommen

Diese Grundsätze sorgen dafür, dass das Meetup eine echte technische Community-Veranstaltung bleibt und keine Marketingplattform wird.

TLS Hot Reload in Kubernetes

Janne Kataja – SIX

Der erste Vortrag widmete sich einer praktischen Herausforderung im Betrieb von Kubernetes-Clustern: TLS-Zertifikatsrotation.

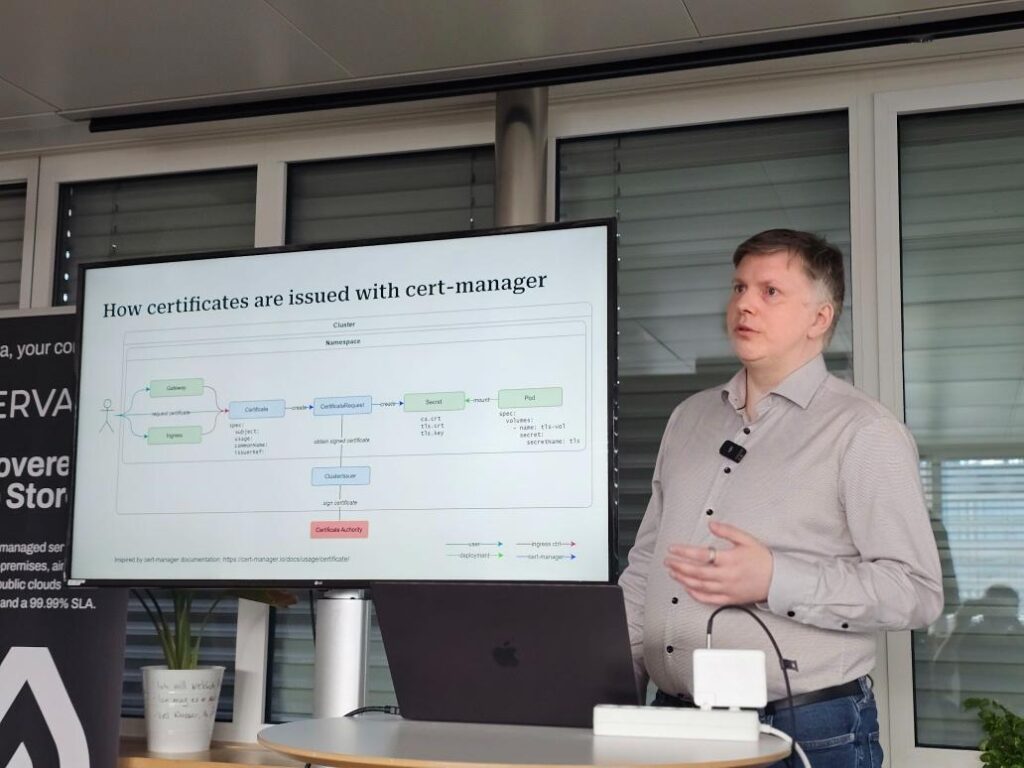
Janne Kataja von SIX erklärte, wie Anwendungen TLS-Zertifikate im laufenden Betrieb neu laden können, ohne dass Pods neu gestartet werden müssen.

In Kubernetes werden Zertifikate häufig in Secrets gespeichert und in Pods gemountet. Wenn ein Zertifikat beispielsweise durch cert-manager erneuert wird, aktualisiert Kubernetes automatisch das gemountete Secret. Anwendungen mit Hot-Reload-Mechanismen können diese Änderungen erkennen und die Zertifikate dynamisch neu laden.

Der Ansatz ermöglicht:

  • nahtlose Zertifikatsrotation
  • höhere Verfügbarkeit
  • den Einsatz kurzlebiger Zertifikate für bessere Sicherheit

Der Vortrag zeigte eindrücklich, wie bereits kleine architektonische Entscheidungen die Stabilität und Betriebssicherheit von Plattformen deutlich verbessern können.

Application-Centric Platforms mit OAM und KubeVela

Raffael Klingler – AXA Schweiz

Der zweite Talk beschäftigte sich mit einem Thema, das in vielen Organisationen aktuell stark an Bedeutung gewinnt: Platform Engineering und Internal Developer Platforms.

Raffael Klingler von AXA stellte das Open Application Model (OAM) vor und zeigte, wie dieser Ansatz den Fokus von Kubernetes-Infrastruktur auf applikationszentrierte Definitionen verschiebt.

Statt komplexe Kubernetes-Manifeste zu schreiben, definieren Entwickler ihre Anwendungen über modulare, wiederverwendbare Bausteine. KubeVela übersetzt diese abstrakten Definitionen anschliessend in konkrete Infrastruktur- und Kubernetes-Ressourcen.

Der Ansatz ermöglicht unter anderem:

  • standardisierte Deployment-Patterns
  • weniger Kubernetes-Komplexität für Entwickler
  • Integration von Cloud-Services und GitOps-Workflows

Gerade im Kontext von Internal Developer Platforms zeigt OAM, wie Kubernetes für Entwicklungsteams zugänglicher und produktiver werden kann.

DevOps für AI: Machine Learning mit Kubeflow in Produktion bringen

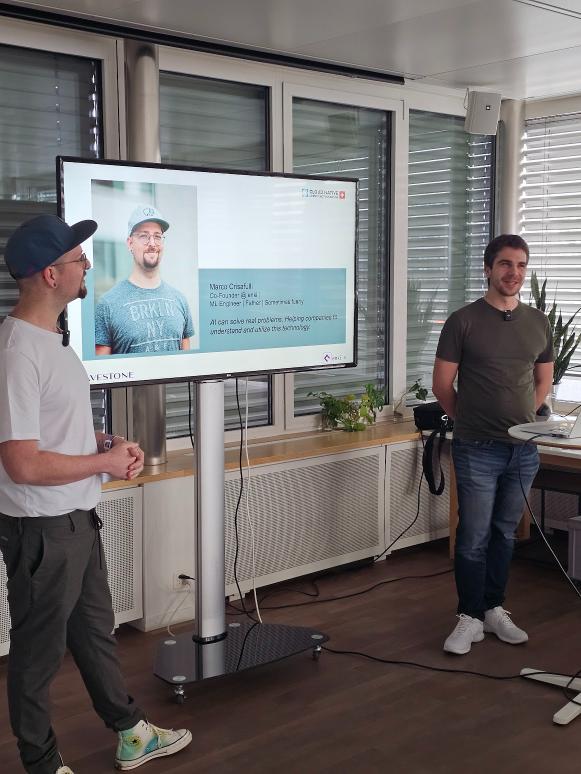
Fabrizio Lazzaretti (Wavestone) & Marco Crisafulli (enki)

Künstliche Intelligenz ist aktuell eines der dominierenden Themen in der IT. Dennoch scheitern viele AI-Initiativen daran, Modelle zuverlässig in Produktion zu betreiben.

Fabrizio Lazzaretti und Marco Crisafulli zeigten in ihrem Vortrag, wie MLOps-Praktiken und Kubeflow helfen können, die Lücke zwischen Data Science und produktiven Systemen zu schliessen.

Kubeflow ermöglicht unter anderem:

  • reproduzierbare Machine-Learning-Pipelines
  • bessere Zusammenarbeit zwischen Teams
  • automatisierte Trainings-Workflows
  • Integration mit dem CNCF-Ökosystem

Anhand eines durchgängigen Praxisbeispiels zeigten die Speaker, wie Organisationen von experimentellen AI-Projekten zu skalierbaren, produktionsreifen ML-Plattformen gelangen können.

Eine zentrale Erkenntnis des Talks: AI-Systeme brauchen starke DevOps-Grundlagen – oft sogar noch mehr als klassische Software.

Bye-bye Ingress-NGINX – Hello Gateway API

Urs Zurbuchen – Airlock

Der letzte Vortrag beschäftigte sich mit einem wichtigen Wandel im Kubernetes-Netzwerk-Ökosystem.

Urs Zurbuchen von Airlock erklärte, warum das traditionelle Ingress-Modell, das lange Zeit stark vom NGINX Ingress Controller geprägt war, zunehmend an seine Grenzen stösst.

Viele Kubernetes-Nutzer kennen Herausforderungen wie:

  • komplexe Konfigurationen
  • eine starke Abhängigkeit von Annotationen
  • Sicherheitsprobleme bei älteren Implementierungen

Die Gateway API entwickelt sich derzeit zu einem neuen Standard, der diese Einschränkungen adressieren soll.

Der Vortrag zeigte:

  • die architektonischen Vorteile der Gateway API
  • warum sie als zukünftiger Standard gilt
  • mögliche Migrationspfade für bestehende Cluster

Für viele Teilnehmende bot der Vortrag einen hilfreichen Überblick darüber, wohin sich Kubernetes Networking in Zukunft entwickelt.

Networking und Apéro

Nach den Vorträgen blieb Zeit für Diskussionen, Austausch und das traditionelle Meetup-Apéro.

Solche Veranstaltungen zeigen immer wieder, wie stark die Schweizer Cloud-Native-Community ist: Engineers aus unterschiedlichsten Unternehmen teilen ihre Erfahrungen, diskutieren neue Technologien und lernen voneinander.

Talks ansehen

Die Aufzeichnungen der Vorträge werden auf dem VSHN TV YouTube Channel veröffentlicht.

Abonniere den Channel, um benachrichtigt zu werden, sobald die Videos online sind.

Teil der Community werden

Das Cloud Native Computing Switzerland Meetup richtet sich an Entwicklerinnen und Entwickler, Architektinnen und Architekten sowie Engineers, die sich für Cloud-Native-Technologien und Open Source interessieren.

Wenn du selbst ein Projekt vorstellen oder einen Talk halten möchtest, kannst du deinen Vorschlag hier einreichen.

Wir freuen uns darauf, dich beim nächsten Meetup zu sehen.

Markus Speth

Marketing, Communications, People

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Allgemein Tech

DevOps für AI: LLMs in Produktion mit Kubernetes und Kubeflow betreiben

9. März 2026

Large Language Models (LLMs) werden zunehmend Teil moderner Softwaresysteme. Von Chatbots und Copilots über Retrieval-Systeme bis hin zu AI-Agenten – immer mehr Organisationen integrieren generative AI in echte Produktionsumgebungen. Während es heute einfacher denn je geworden ist, AI-Prototypen zu bauen, bleibt der zuverlässige Betrieb von LLMs in Produktion eine grosse Herausforderung.

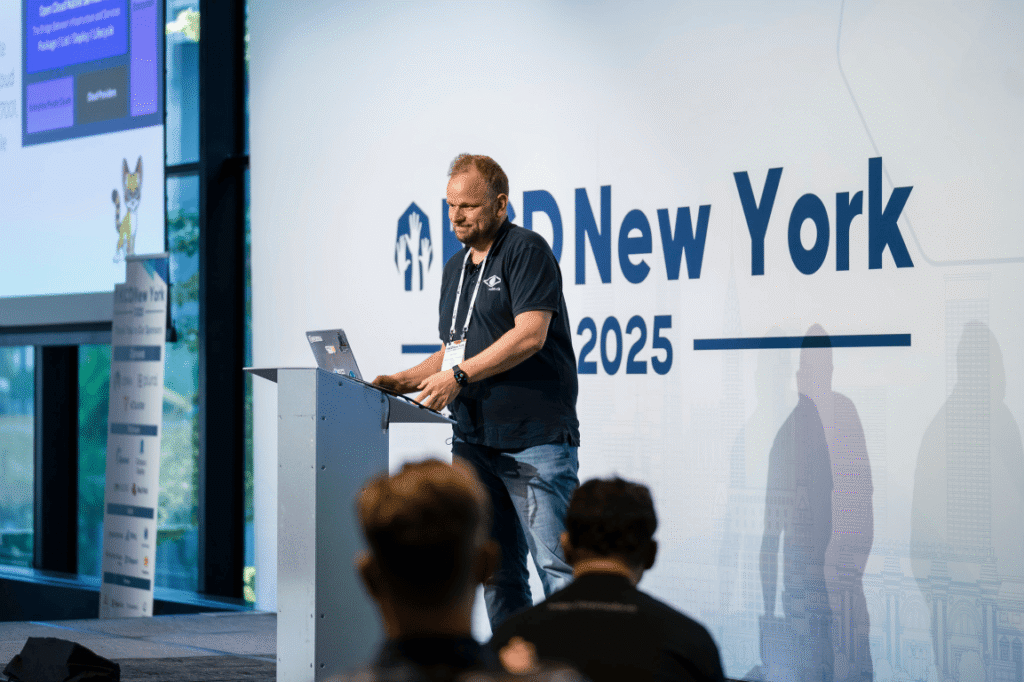
Auf den Kubernetes Community Days New York teilte Aarno Aukia praktische Einblicke, was es braucht, um LLMs mit bewährten DevOps-Praktiken zu betreiben. Sein Vortrag machte eine wichtige Realität deutlich: AI-Systeme benötigen weiterhin starke DevOps-Fundamente – möglicherweise sogar mehr als klassische Softwaresysteme.

Aarno Aukia’s Talk am KCD New York

DevOps trifft auf AI

DevOps war schon immer darauf ausgerichtet, die Lücke zwischen Entwicklung und Betrieb zu schliessen. Entwickler konzentrieren sich auf die Anwendungslogik und Daten, während Operations-Teams dafür sorgen, dass Software zuverlässig in Produktion läuft. In den letzten zehn Jahren haben sich DevOps-Praktiken rund um Automatisierung, Observability und Continuous Delivery stark weiterentwickelt.

In vielen Organisationen folgt Software heute einer etablierten Pipeline: Entwickler committen Code in Git, automatisierte CI/CD-Pipelines bauen und paketieren die Anwendung, und Kubernetes deployt und betreibt sie in Produktion. Monitoring- und Logging-Systeme schaffen Transparenz darüber, wie sich die Anwendung verhält, sodass Entwickler sie kontinuierlich verbessern können.

Diese Feedback-Schleife ist zum Rückgrat moderner Cloud-Native-Entwicklung geworden.

Wenn jedoch AI ins Spiel kommt, verändert sich dieses Modell in mehreren wichtigen Punkten.

AI-Systeme verhalten sich anders

Einer der grössten Unterschiede zwischen klassischen Anwendungen und AI-basierten Systemen ist die Deterministik. Traditionelle Software verhält sich vorhersehbar: Bei gleichem Input entsteht immer derselbe Output. LLMs funktionieren dagegen völlig anders.

Large Language Models sind probabilistische Systeme. Sie erzeugen Antworten, indem sie das nächste Token basierend auf dem Kontext vorhersagen und damit statistische Entscheidungen darüber treffen, was als Nächstes folgt. Das bedeutet, dass selbst kleine Änderungen im Prompt oder in der Eingabe zu sehr unterschiedlichen Ergebnissen führen können.

Eine scheinbar harmlose Anpassung eines System-Prompts kann das Verhalten eines Modells komplett verändern. In einem Beispiel führte bereits das Hinzufügen eines saisonalen Themas zu einem Chatbot-Prompt dazu, dass das Modell grundlegende Fragen nicht mehr korrekt beantworten konnte.

Für Operations-Teams entsteht dadurch eine neue Kategorie von Komplexität. Anstatt deterministische Systeme zu debuggen, müssen sie nun Systeme betreiben, deren Ergebnisse sich je nach Kontext subtil verändern können.

Testing wird dadurch deutlich komplexer.

Die Herausforderung beim Testen von AI

Klassisches Software-Testing ist vergleichsweise einfach. Ein Test liefert einen Input und überprüft, ob der Output exakt dem erwarteten Wert entspricht.

AI-Systeme passen nicht in dieses Modell. Wenn ein LLM eine Antwort generiert, kann diese korrekt sein, auch wenn sie sich in der Formulierung vom erwarteten Ergebnis unterscheidet. Gleichzeitig kann sie subtile sachliche Fehler oder Halluzinationen enthalten.

Zu bestimmen, ob eine Antwort akzeptabel ist, erfordert daher oft eine semantische Bewertung statt eines strikten Vergleichs. In manchen Fällen verwenden Organisationen sogar ein weiteres LLM, um die Ausgabe des ersten Modells zu bewerten. Dadurch entsteht ein völlig neues Testing-Paradigma, das viele Teams erst noch lernen zu beherrschen.

Mehr Artefakte zu verwalten

AI-Systeme bringen ausserdem zusätzliche Artefakte mit sich, die verwaltet und versioniert werden müssen.

In klassischen DevOps-Pipelines bestehen die wichtigsten Artefakte aus Source Code und Container Images. Bei AI-Workloads kommen jedoch weitere Komponenten hinzu: Datensätze, Trainingsartefakte, Prompts und Modelldateien. Diese Modelle sind oft sehr gross – teilweise mehrere Dutzend Gigabyte – und müssen sorgfältig gespeichert und versioniert werden.

Ohne saubere Versionierung wird es extrem schwierig, Probleme zu debuggen oder Ergebnisse später zu reproduzieren. Wenn sich ein Modell unerwartet verhält, müssen Teams genau wissen, welche Modellversion, welcher Datensatz und welche Konfiguration beim Deployment verwendet wurden.

Das erhöht die operative Komplexität von AI-Systemen erheblich.

Observability wird kritisch

Da LLMs nicht deterministisch sind, wird Observability noch wichtiger als in klassischen Systemen.

Logging muss deutlich mehr Kontext erfassen als bisher. Statt nur Anwendungsereignisse zu protokollieren, müssen Teams möglicherweise den vollständigen Prompt, die Modellantwort, die Modellversion und weitere Konfigurationsparameter speichern. Nur so können Betreiber später nachvollziehen, was genau passiert ist.

Ohne detaillierte Observability kann das Debugging von AI-Systemen schnell unmöglich werden.

Offene Modelle vs. gehostete APIs

Eine weitere wichtige operative Entscheidung ist die Wahl zwischen geschlossenen und offenen Modellen.

Gehostete AI-APIs bieten Komfort und leistungsstarke Funktionen, bringen aber auch Einschränkungen mit sich. In vielen Fällen haben Organisationen keine Kontrolle darüber, wann Modellupdates stattfinden oder welche Minor-Version gerade aktiv ist. Das kann Debugging und Reproduzierbarkeit erschweren.

Open-Weight- oder Open-Source-Modelle bieten dagegen mehr Kontrolle im Betrieb. Sie können heruntergeladen, versioniert, lokal getestet und auf eigener Infrastruktur betrieben werden. Organisationen können so selbst entscheiden, wann und wie Updates ausgerollt werden.

Gerade für regulierte Branchen wie Finanzwesen, Gesundheitswesen oder öffentliche Verwaltung ist dieses Mass an Kontrolle entscheidend.

Kubernetes als Fundament

Hier kommt Kubernetes als zentraler Bestandteil der AI-Infrastruktur ins Spiel.

Kubernetes löst bereits viele operative Herausforderungen beim Betrieb verteilter Systeme. Es bietet Mechanismen für Container-Orchestrierung, Ressourcenmanagement, Autoscaling und Fehlertoleranz. Für AI-Workloads besonders wichtig ist die Fähigkeit, auch GPU-Ressourcen zu verwalten.

Der Betrieb von Kubernetes selbst ist jedoch nicht trivial – wie wir auch in unserem Artikel Beste Kubernetes Distributionen 2026 – und warum du sie vielleicht nicht selbst betreiben solltest beschreiben. Produktionscluster zu betreiben erfordert erhebliche operative Erfahrung.

Kubeflow und der Machine-Learning-Lifecycle

Kubeflow erweitert Kubernetes um spezialisierte Komponenten für Machine-Learning-Workflows. Es hilft dabei, den gesamten Lebenszyklus von AI-Modellen zu verwalten – vom Training bis zum Betrieb der Inferenz.

Mit Kubeflow Pipelines können Teams Workflows für die Modellentwicklung und das Training automatisieren. Diese Pipelines orchestrieren komplexe Prozesse wie Datenvorverarbeitung, Trainingsläufe, Evaluationen und das Verpacken von Modellen für Deployments.

Für viele Organisationen, die LLMs einsetzen, liegt der Fokus jedoch nicht auf dem Training eigener Modelle, sondern darauf, bestehende Modelle zuverlässig in Produktion zu betreiben.

Hier kommt KServe ins Spiel.

LLMs mit KServe betreiben

KServe ist ein Kubernetes-natives Framework für Model Serving, das das Deployment und den Betrieb von AI-Modellen vereinfacht. Es ermöglicht Teams, Inferenzservices auf Kubernetes über standardisierte APIs bereitzustellen.

Ein typisches Deployment besteht aus einem Container, der einen Model Server betreibt, häufig basierend auf Runtimes wie vLLM. Der Container lädt das Modell, nutzt GPU-Ressourcen für die Inferenz und stellt einen API-Endpunkt für Anwendungen bereit.

KServe integriert sich mit Kubernetes-Autoscaling-Mechanismen und Observability-Tools, sodass AI-Workloads dynamisch skaliert und ihr Verhalten in Produktion überwacht werden kann.

Da alles als Kubernetes-Ressource läuft, können Teams dieselben DevOps-Praktiken nutzen, die sie bereits für andere Anwendungen einsetzen.

Ein schnell wachsendes Ökosystem

Das Ökosystem rund um AI-Infrastruktur entwickelt sich derzeit extrem schnell. Neue Projekte entstehen laufend, um die besonderen Herausforderungen beim Betrieb von LLMs im grossen Massstab zu adressieren.

Ein Beispiel ist LLMD, ein Kubernetes-Operator speziell für LLM-Inferenz. Er baut auf bestehenden Technologien wie vLLM auf, ergänzt diese jedoch um zusätzliche Funktionen wie Request-Routing, Modellselektion, Caching und intelligentes Scaling.

Solche Tools zeigen, wie sich das Cloud-Native-Ökosystem an die operativen Anforderungen von AI-Workloads anpasst.

AI braucht weiterhin DevOps

Trotz des grossen Hypes rund um generative AI bleibt eine zentrale Erkenntnis bestehen: AI-Systeme brauchen weiterhin starke operative Grundlagen.

LLMs in Produktion zu betreiben bedeutet weit mehr, als einfach eine API aufzurufen. Es erfordert sorgfältiges Management von Modellen, Infrastruktur, Observability und Deployment-Prozessen.

Kubernetes und Kubeflow bieten eine leistungsfähige Plattform, um diese Herausforderungen zu bewältigen. Durch die Anwendung bewährter DevOps-Prinzipien auf AI-Systeme können Organisationen Plattformen aufbauen, die nicht nur intelligent, sondern auch zuverlässig und skalierbar sind.

Während AI zunehmend zum Standardbestandteil moderner Anwendungen wird, wird die Fähigkeit, diese Systeme effizient zu betreiben, genauso wichtig wie die Modelle selbst.

Genau hier kommen Plattformansätze ins Spiel. Anstatt dass jedes Team komplexe Stacks selbst aufbauen und betreiben muss, können Plattformen fertige Services auf Kubernetes bereitstellen. Ein Beispiel dafür ist Servala – Sovereign App Store, ein Kubernetes-nativer Marktplatz, der Organisationen mit einem Katalog von Managed Cloud-Native-Services verbindet, darunter Datenbanken, Storage, Developer Tools und AI-fähige Infrastrukturkomponenten.

Markus Speth

Marketing, Communications, People
Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Allgemein Tech

Jetzt verfügbar: DevOps in der Schweiz Report 2025 🚀

25. Juni 2025

Wir freuen uns riesig, die sechste Ausgabe unseres „DevOps in der Schweiz“ Reports zu veröffentlichen – und diesmal mit einem ganz besonderen Fokus: Platform Engineering und künstliche Intelligenz (AI)! 🤖

Von Januar bis April 2025 haben wir eine Studie mit Fachleuten aus der Schweizer Tech-Community durchgeführt. Das Ergebnis: ein aufschlussreicher Einblick, wie DevOps-Teams in der Schweiz heute arbeiten – welche Tools sie einsetzen, wie ihre Teams aufgebaut sind, welche Herausforderungen sie beschäftigen und wo AI bereits konkret eingesetzt wird.

💡 Sneak Peek gefällig?

  • 💡 Schweizer Unternehmen fragen nicht mehr ob sie DevOps einführen sollen – sondern wie sie es skalieren können.
  • 📈 Platform Engineering und KI verändern, wie Teams Software schneller, sicherer und intelligenter ausliefern.
  • 💡 Jede dritte Schweizer DevOps-Organisation nutzt bereits KI in der Produktion – etwa für Code-Reviews, CI/CD-Optimierung und Architekturunterstützung.
  • Ein weiteres Drittel steht kurz davor, nachzuziehen.
  • 💡 54 % der Schweizer Unternehmen haben inzwischen dedizierte Platform-Engineering-Teams.
  • Internal Developer Platforms (IDPs) werden zur Geheimwaffe, um Autonomie zu ermöglichen und Komplexität zu reduzieren.
  • 💡 Devs sagen Ja zu KI!
  • 79 % der Schweizer Entwickler:innen fühlen sich wohl dabei, KI in ihren Workflows einzusetzen – aber nur 20 % halten sie für vollständig bereit.
  • Der Report zeigt: KI ist vielversprechend, braucht aber bessere Messbarkeit und mehr Vertrauen, um skalieren zu können.

All das (und noch viel mehr!) findest du kompakt zusammengefasst im PDF-Report (nur auf Englisch). Wie schon im Vorjahr enthält der Report eine Executive Summary zu Beginn – perfekt für alle mit wenig Zeit.

📥 Jetzt herunterladen

Viel Spass beim Lesen – wir freuen uns sehr auf dein Feedback! 🙌

Du kannst den DevOps Report 2025 hier herunterladen. Viel Spass beim Lesen und wir freuen uns auf dein Feedback!

Markus Speth

Marketing, Communications, People

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Allgemein Servala Tech

Redis 8 jetzt im VSHN Application Catalog verfügbar und Redis ist wieder Open Source!

11. Juni 2025

Redis 8 ist ab sofort im VSHN Application Catalog verfügbar und Redis ist als Open Source zurück!
Wir freuen uns riesig, dir mitzuteilen: Redis 8 ist ab sofort im VSHN Application Catalog verfügbar – und dieses Release ist etwas ganz Besonderes: Redis ist offiziell wieder Open Source!

Aber das ist noch nicht alles: Redis ist jetzt auch auf Servala verfügbar – dem offenen, cloud-nativen Service Hub von VSHN, der Entwickler:innen, Softwareanbieter und Cloud Provider über verschiedene Infrastrukturen hinweg verbindet.

Warum das so wichtig ist

Redis gehört seit Jahren zu den beliebtesten In-Memory-Datenbanken für Entwickler:innen und DevOps-Teams. Doch Lizenzänderungen in den letzten Versionen haben für viele Cloud-native Nutzer:innen und offene Ökosysteme Probleme verursacht. Mit Version 8 ändert sich das endlich: Redis kehrt zu seinen Open-Source-Wurzeln zurück und steht jetzt unter der GNU AGPLv3-Lizenz.

„Redis 8 bringt Redis zurück zu seinen Open-Source-Wurzeln. Die zukünftige Entwicklung von Redis wird unter der AGPLv3-Lizenz stattfinden.“
– Redis-Team, offizielle Ankündigung

Das bedeutet: mehr Transparenz, bessere Zusammenarbeit und langfristige Nachhaltigkeit für alle, die Redis als festen Bestandteil ihres Tech-Stacks einsetzen.

Redis 8 mit VSHN und Servala: Vollständig gemanagt & hochverfügbar

Mit Redis 8 im VSHN Application Catalog und auf Servala bekommst du mehr als nur die neueste Open-Source-Version:

  • Produktionsreife Deployments auf Kubernetes und OpenShift
  • Garantierte Verfügbarkeit, Monitoring und automatisches Failover
  • Lifecycle-Management inkl. Updates und Sicherheitspatches
  • Flexibilität beim Cloud-Anbieter – in deiner Infrastruktur oder über unsere Partner
  • Self-Service-Provisionierung über Servala mit integrierter Automatisierung

Egal ob du Redis intern nutzt oder als Service für Teams und Kund:innen bereitstellst – wir kümmern uns darum.

Unterstützte Versionen

Wir unterstützen weiterhin die meistgenutzten Redis-Versionen – ab sofort gehört auch Redis 8 offiziell zu unserem gepflegten Portfolio.
👉 Schau dir die vollständige Liste auf unserer VSHN Redis Produktseite oder der Servala Redis Seite an.

Warum Redis 8 über VSHN oder Servala nutzen?

✅ Wieder vollständig Open Source und Community-getrieben
✅ Kubernetes-native, GitOps-fähige Deployments
✅ Hochverfügbar mit Failover- und Backup-Strategien
✅ Integriert in deine Infrastruktur oder als Managed Service
✅ Unterstützt von VSHN – den DevOps-Experten hinter Servala

Redis 8 ist ein Meilenstein für die Open-Source-Welt – und wir bringen es in deine produktive Umgebung!

🔧 Du brauchst Unterstützung bei der Integration von Redis 8?
📬 Kontaktiere uns für eine kostenlose Beratung!
📩 Abonniere unsere Newsletter, um über Open-Source-News und neue Services informiert zu bleiben.

Markus Speth

Marketing, Communications, People
Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Servala Tech

Die technischen Herausforderungen hinter Servala: Standardisierung der Applikationsbereitstellung

14. Apr. 2025

In diesem Nachfolgeartikel zu unserer Einführung in Servala werfen wir einen Blick auf die technischen Herausforderungen, Managed Services für Cloud Provider überall verfügbar zu machen. Erfahre, wie die wiederholte und inkonsistente Natur von Applikationspaketierung, -bereitstellung und -betrieb unsere Vision für Standardisierung inspiriert hat.

Wir gehen auf die Probleme ein, mit denen Platform Engineers heute konfrontiert sind – darunter inkonsistentes Verhalten von Containern, unvorhersehbare Helm Charts und das Chaos des Day-2-Betriebs im Hinblick auf Sicherheit, Konfiguration und Abhängigkeiten.

Lerne, wie Servalas vorgeschlagene Open Standards die Landschaft für folgende Gruppen verändern können:

  • Softwareanbieter – Schnellere Markteinführung und grössere Reichweite ohne operativen Aufwand
  • Cloud Provider – Erweiterung der Servicekataloge mit Enterprise-fähigen Managed Services
  • Endnutzer – Selbstbedienung mit konsistenten, sicheren und konformen Applikationen

Begleite uns auf dieser Reise, um Applikationsbereitstellung zu vereinfachen und Managed Services für alle zugänglich zu machen.

In unserer Einführung in Servala haben wir die technischen Herausforderungen erwähnt, Softwareanbieter dazu zu befähigen, sich selbst auf unserer Plattform zu integrieren. Während wir Servala 2025 weiter aufbauen, widmen wir uns der grundlegendsten Herausforderung: Einen standardisierten Ansatz für Applikationsbereitstellung zu schaffen. Lass uns diese Herausforderungen und unsere vorgeschlagene Lösung im Detail anschauen.

Die wiederholende Natur des Applikationsmanagements

In den letzten Jahren haben wir bei VSHN unzählige Applikationen im Rahmen unseres Managed Services-Angebots betreut – dem Fundament von Servala. Für jede einzelne Applikation mussten wir immer wieder dieselben mühsamen Aufgaben erledigen:

Packaging: Die Applikation in ein deploybares Format bringen, typischerweise durch Erstellen eines OCI-konformen Container-Images, das mit Docker, Podman, Kubernetes und OpenShift kompatibel ist. Der Packaging-Prozess wird automatisiert, sodass er bei jeder neuen Version ausgelöst wird.

Deployment: Die verpackte Applikation automatisiert auf das Zielsystem ausrollen – nicht manuell. Die meisten Deployments umfassen mehrere Umgebungen wie Test, Staging, Pre-Prod und Produktion oder ermöglichen Self-Service-Bereitstellung für SaaS. Oft ist dies mit dem Erstellen von Helm Charts und dem Aufsetzen von Automatisierungspipelines oder APIs verbunden, z.B. über Kubernetes-Operatoren (wie Crossplane).

Day-2-Betrieb: Nach dem Deployment kommen Aufgaben wie das Sammeln von Metriken, Einrichten von Alerts, Updaten der Applikation, Skalierung bei Performanceproblemen, Backup und Restore von Daten, Log-Analyse, 24/7-Support und die Einhaltung von Compliance-Vorgaben dazu – sowie viele weitere Betriebsaufgaben.

Die aktuelle Herausforderung für Servala

Diese Schritte immer und immer wieder durchzuführen, wird ermüdend. Die gleichen Probleme zu lösen, sobald wir uns um eine neue Applikation kümmern, fühlt sich nicht wirklich wertstiftend an. In der Realität müssen wir mit einer Vielzahl unterschiedlicher Herangehensweisen umgehen. Es ist eine grosse Belastung für Engineers, all diese Varianten zu unterstützen. Einzelne Teile der oben erwähnten Funktionen sind meist schon erledigt – zum Beispiel gibt es bereits Container-Images, aber jedes davon verhält sich anders. Das bedeutet, dass wir müssen jedes Mal herausfinden müssen, wie es in den nächsten Schritt integriert werden kann. Dasselbe gilt für die verschiedenen Helm Charts da draussen. Standardisierung würde uns diese Last abnehmen, den Prozess effizienter und weniger repetitiv machen.

Das Kernproblem liegt in der Flexibilität der verwendeten Tools. Container-Images unterscheiden sich massiv in ihrer Bauweise und ihrem Verhalten. Helm Charts akzeptieren Parameter in inkonsistenten Formaten. Zum Beispiel kann ein Container-Image in einem Chart als img, image oder image-registry bezeichnet sein – je nachdem, wer es geschrieben hat.

Security Scans und Compliance Reports sind von Applikation zu Applikation unterschiedlich. Manche bringen SBOMs (Software Bill of Materials) mit, bei anderen müssen diese manuell erstellt werden. Die Konfigurationshandhabung ist genauso inkonsistent: Manche Applikationen setzen auf Umgebungsvariablen, andere erwarten Konfigurationsdateien an bestimmten Orten, wieder andere benötigen eigene Konfigurations-APIs.

Auch der Day-2-Betrieb unterscheidet sich stark. Manche Applikationen exportieren Metriken im Prometheus-Format, andere gar nicht. Identische Metriken haben unterschiedliche Namen, und Logging-Formate reichen von strukturiertem JSON bis zu einfachem Plaintext. Abhängigkeitsmanagement wird oft vernachlässigt – es gibt kaum Infos zu benötigten Services oder Komponenten. Das Betreiben dieser Applikationen wird zum nervenaufreibenden „Whack-a-Mole“-Spiel.

Wir müssen diese grundlegenden Inkonsistenzen lösen, damit Servala skalieren kann und Softwareanbieter ihre Applikationen einfacher onboarden können.

Unsere vorgeschlagene Lösung: Standardisierung

Wie lassen sich diese Hindernisse überwinden? Unser Vorschlag: eine Sammlung von Dokumenten definieren, die Muster für alle notwendigen Teile der Applikationsbereitstellung über Servala beschreiben. Du kannst diese Dokumente auch als Spezifikationen, Golden Paths, Patterns, Standards, Konventionen oder Defaults verstehen. Ziel ist es, einen gemeinsam abgestimmten Weg zu dokumentieren, um die genannten Aufgaben zu lösen – sodass wir sie nicht immer wieder neu durchdenken müssen.

Aber das nur für uns zu machen, fühlt sich nicht richtig an. Wir bei VSHN leben Open Source und Open Standards und wollen gemeinsam mit anderen einen definierten Weg finden. Daher schlagen wir vor, eine Gruppe von Menschen aus verschiedenen Unternehmen zusammenzubringen, um diese Muster gemeinsam zu dokumentieren und sich darauf zu einigen.

Unsere Vision: Eine transformierte Landschaft der Applikationsbereitstellung

Wie wird Applikationsbereitstellung aussehen, wenn die Servala-Spezifikationen weit verbreitet sind? Die Vorteile wären für alle Beteiligten transformativ:

Für Softwareanbieter:

  • Schnellere Markteinführung: Anstatt Monate in den Aufbau von Deployment-, Monitoring- und Wartungssystemen zu investieren, können Anbieter sich auf ihr Kernprodukt konzentrieren und auf Servalas standardisierte Delivery-Mechanismen setzen, um global Cloud Provider zu erreichen.
  • Weniger operativer Aufwand: Wer sich an die Servala-Spezifikation hält, übernimmt automatisch bewährte Praktiken wie Monitoring, Metriken, Logs, Backups etc. – ganz ohne eigenes Operations-Team.
  • Grössere Marktreichweite: Die Möglichkeit, auf jedem Servala-kompatiblen Cloud Provider zu deployen, eröffnet neue Märkte ohne zusätzlichen Engineering-Aufwand.
  • Bessere Sicherheitslage: Standardisierte Security-Scans, Compliance-Berichte und Konfigurationsmanagement senken Risiken drastisch – selbst ohne dediziertes internes Security-Know-how.

Für Cloud Provider:

  • Erweiterte Servicekataloge: Provider können sofort Dutzende Managed Services mit einheitlichen Betriebsstandards anbieten – ein enormer Mehrwert.
  • Operationale Konsistenz: Alle Services folgen denselben Mustern für Monitoring, Alerts und Wartung – das reduziert die Komplexität beim Betrieb verschiedenster Third-Party-Applikationen.
  • Wettbewerbsdifferenzierung: Kleinere Cloud Provider können mit Hyperscalern mithalten, indem sie vergleichbare Kataloge an Managed Services anbieten.

Für EndnutzerInnen:

  • Dank Servalas standardisierten Bereitstellungsmechanismen kannst du komplexe Managed Services mit Vertrauen deployen – in dem Wissen, dass sie konsistenten betrieblichen Mustern folgen. Das gibt dir Kontrolle und Sicherheit im Betrieb.
  • Die operativen Schnittstellen bleiben unabhängig von der jeweiligen Applikation konsistent, was dir ein vorhersehbares und sicheres Nutzungserlebnis bietet. Diese Vorhersehbarkeit stärkt das Vertrauen in Stabilität und Zuverlässigkeit des Systems.
  • Enterprise-Readiness: Alle Services beinhalten automatisch Sicherheitsfunktionen, Backup/Restore, Monitoring und andere Enterprise-Features – ganz ohne individuellen Integrationsaufwand.
  • Vereinfachte Compliance: Standardisierte Security-Scans und Compliance-Reports machen regulatorische Audits einfacher und weniger ressourcenintensiv.
  • Klarheit bei Abhängigkeiten: Durch transparente Darstellung von Service-Abhängigkeiten und Kompatibilitätsanforderungen werden Deployment-Fehler und Konfigurationsprobleme reduziert.

Die Spezifikationsbereiche von Servala

Wir planen, Muster für folgende Bereiche zu dokumentieren:

Verhalten von Container-Images: Wo werden Daten gespeichert? Wie werden Ports freigegeben? Wie verhält sich der Entry Point? Mit welchen Berechtigungen läuft die Applikation?

Helm Chart „API“: Wie verhalten sich die Standardwerte? Wie sieht die Struktur der Konfiguration aus?

Einheitlicher Betriebsrahmen:

  • Backup und Restore: Standardisierte Schnittstellen für konsistente Backups von Applikationen und Daten, mit klar definierten Wiederherstellungspfaden und Verifikationsmethoden
  • Metriken: Klar definierte Endpunkte für Applikationsmetriken zur Alarmierung, Überwachung und Performance-Einblicke
  • Alerting und Monitoring: Gemeinsame Alarmdefinitionen, Schweregrade und Reaktionserwartungen über alle Applikationen hinweg
  • Logging-Standards: Einheitliche Logformate, Aufbewahrungsrichtlinien und Suchmöglichkeiten zur Vereinfachung der Fehleranalyse
  • SLA-Definitionen: Standardisierte Metriken zur Messung und Berichterstattung von Verfügbarkeit, Performance und Zuverlässigkeit
  • Wartungsfenster: Klare Protokolle zur Koordination und Kommunikation von Wartungen mit minimaler Unterbrechung
  • Abrechnung: Einheitliche Art der Abrechnung der Service-Nutzung
  • Security Scanning und Compliance: Standardisierte Ansätze für Schwachstellenmanagement, Sicherheitsrichtlinien und Compliance-Berichterstattung über alle Applikationen hinweg
  • Konfigurationsmanagement: Einheitliche Muster für Konfigurationshandling, Secret Management und Laufzeit-Rekonfiguration
  • Abhängigkeitsmanagement: Klare Deklaration und Handhabung von Service-Abhängigkeiten, inklusive Versionierungsanforderungen und Kompatibilitätsmatrizen

Self-Service API-Architektur: Standardisierte Strukturen für Kubernetes-Ressourcen vorschlagen, um vorhersehbare Schnittstellen für Applikationsmanagement in verschiedenen Umgebungen zu schaffen

Bisherige Arbeiten, auf denen wir aufbauen möchten

Es gibt bereits erfolgreiche Standardisierungsinitiativen, auf die wir aufbauen wollen:

OCI Image Format

Nach Jahren der Fragmentierung im Container-Bereich hat das Open Container Initiative (OCI) einen einheitlichen Image-Standard geschaffen, der von Tools wie Docker und Podman genutzt wird. Dieser Standard definiert Dateisystempfade (z. B. /var/lib/docker/), Image-Layering und Interoperabilität mit Registries wie Docker Hub, GHCR und Quay.

Kubernetes als Container-Orchestrator

Kubernetes hat sich als De-facto-Standard zur Verwaltung von Containerflotten etabliert. Es bietet eine einheitliche API zur Steuerung von Rechenleistung, Netzwerk und Storage – unabhängig vom Infrastrukturanbieter.

Pod- und Container-Lifecycle-Konventionen in Kubernetes

Die Community hat das Verhalten von Applikationen bei Lifecycle-Events wie Start, Shutdown und Health Checks standardisiert. Anwendungen reagieren nun vorhersehbar auf Restarts und Node Drainings, was den Alltag von Platform Engineers stark vereinfacht. Lifecycle Hooks sind zum Standard geworden.

Prometheus-Metriken

Viele Applikationen exportieren Metriken im Prometheus/OpenMetrics-Format über einen /metrics-Endpunkt. Es gibt etablierte Namenskonventionen (z. B. http_requests_total). Obwohl nicht alles einheitlich ist, ist dies einer der am weitesten akzeptierten inoffiziellen Standards – genutzt von Applikationen, Exportern, Sidecars und Service Monitors.

SBOM (Software Bill of Materials)

Dank offener SBOM-Standards und Unterstützung durch Tools wie GitHub, GitLab und Docker ist das Erstellen und Konsumieren von SBOMs heute Best Practice. Die EU Cyber Resilience Act (CRA) verpflichtet mittlerweile zur Nutzung von SBOMs – sowohl für proprietäre als auch für Open-Source-Software.

12-Factor App

Auch wenn es noch Unterschiede gibt, verdient das 12factor.net-Manifest eine lobende Erwähnung. Es legte 2011 den Grundstein für Cloud-Native Applikationen und beeinflusst Architektur und Plattformdesign bis heute: Konfiguration über Umgebungsvariablen, Statelessness, Logging auf stdout – vieles davon ist heute Best Practice und wird von Plattformen oft indirekt erzwungen.

Helm Chart Best Practices

Die Helm-Community hat auf die strukturelle Inkonsistenz von Charts reagiert und Best Practices, Guidelines sowie Tools wie helm lint und helm create bereitgestellt. Auch wenn diese nicht überall angewendet werden, setzen Projekte wie Bitnami, KubeApps und Backstage zunehmend auf diese Konventionen – ein solides Fundament für Servalas Standardisierungsbemühungen.

OpenAPI / Swagger

Die OpenAPI-Initiative hat die API-Standardisierung stark vorangetrieben. Sie erlaubt maschinenlesbare API-Definitionen, automatisierte SDK-Generierung, Tests, Mocks und lesbare Dokumentation. Sie ist breit akzeptiert – von Kubernetes CRDs bis hin zu GitHub APIs – und bringt Konsistenz und Interoperabilität in API-Design und -Nutzung.

OpenServiceBroker API

Wir haben diese API bereits implementiert und nutzen sie mit einigen Kunden. Sie bietet jedoch keinen deklarativen, Cloud-Nativen Ansatz für Service Listing und Provisionierung.

Crossplane

Wir sind Fans von Crossplanes deklarativem Ansatz für Service-Definitionen und -Instanziierung. Die „Composite Resource Definitions“ (XRDs) erlauben das Erstellen von benutzerdefinierten CRDs mit konsistenter Struktur. Servala ersetzt Crossplane nicht – wir nutzen es unter der Haube.

Open Application Model (OAM)

OAM unterstützt Servalas Mission, indem es einen plattformagnostischen, standardisierten Weg bietet, Cloud-Native Applikationen zu definieren. Es trennt sauber Kernlogik (Components), Betriebsfeatures (Traits) und Abhängigkeiten (Scopes). Mit wiederverwendbaren Definitionen für Metriken, Backups und Autoscaling hilft OAM, die Fragmentierung von Helm Charts und Container Images zu überwinden – eine interessante Grundlage für Servalas Spezifikation.

Platform Specification

Die Platform Spec-Initiative passt perfekt zu Servalas Vision: Sie definiert eine standardisierte YAML-basierte Schnittstelle zwischen Entwicklern und Platform Engineers für Deployment und Management – inklusive Container Images, Umgebungsvariablen, Secrets, Service Bindings und Regeln fürs Ausrollen. Damit lassen sich viele der Inkonsistenzen in Helm Charts und beim Laufzeitverhalten lösen. Durch die Übernahme oder Anlehnung an Platform Spec kann Servala Onboarding vereinfachen, Integrationsaufwand reduzieren und Plattformunabhängigkeit fördern.

Cloud Native Application Bundle (CNAB)

Die CNAB-Spezifikation unterstützt Servalas Ziele durch ein portables, standardisiertes Format für das Packaging und die Verteilung komplexer Applikationen – inklusive Kubernetes-Manifeste, Helm Charts, Terraform-Pläne und Skripte. CNAB definiert ein konsistentes Format für Code, Konfiguration und Lifecycle-Operationen (Install, Upgrade, Uninstall). Damit lässt sich ein einheitliches, wiederholbares Deployment ermöglichen – ideal für komplexe Managed Services über verschiedene Umgebungen hinweg.

Der Weg nach vorn

Servala will das Onboarding von Applikationen um den Faktor 10 beschleunigen – von Wochen auf Stunden oder Tage – und gleichzeitig die Zuverlässigkeit durch bewährte, konsistente Muster für Deployment und Betrieb dramatisch steigern. Wir haben begonnen, diese Standards in unsere Entwicklungs-Roadmap zu integrieren, doch für den Erfolg ist eine breite Zusammenarbeit in der Branche entscheidend.

Wir laden Softwareanbieter, Cloud Provider und Platform Engineers ein, gemeinsam mit uns an der offenen und kollaborativen Gestaltung dieser Standards zu arbeiten. Mit einem soliden Fundament kann Servala die Art und Weise, wie Managed Services bereitgestellt werden, neu definieren: Cloud Provider können ihre Kataloge erweitern und Softwareanbieter werden zu SaaS-Providern – ohne grossen operativen Aufwand.

Bleib auf dem Laufenden

Erfahre immer als Erste oder Erster die neuesten Nachrichten zu Servala. Gib einfach deine E-Mail-Adresse unten ein:

Get in touch with us

Dieses Feld dient zur Validierung und sollte nicht verändert werden.
Name(erforderlich)
Let us know how we can help.
Newsletter

Was kommt als Nächstes?

Im Jahr 2025 werden wir uns darauf konzentrieren, Softwareanbietern die Möglichkeit zu geben, sich selbst in die Servala-Service-Plattform einzubinden. Mehr Informationen zu Warum wir Servala gestartet haben findest du auch in unserem Servala Launch Announcement.

Kontaktiere uns

Interessiert, mehr zu erfahren? Buche ein Meeting oder schreib uns und finde heraus, wie Servala dir helfen kann. Erlebe die Zukunft von Cloud Native Services auf servala.com. 🚀

Markus Speth

Marketing, Communications, People
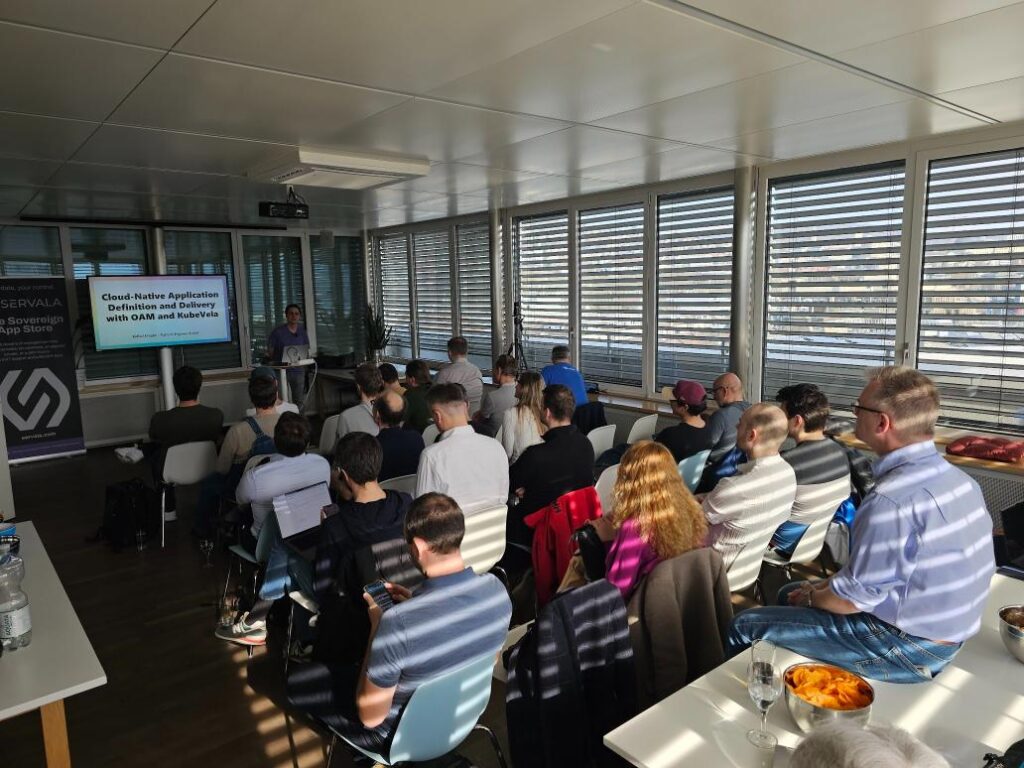
Allgemein Tech

Jetzt verfügbar: DevOps in der Schweiz Report 2024

12. Sep. 2024

Wir freuen uns, die fünfte Ausgabe unseres Reports „DevOps in der Schweiz“ vorstellen zu dürfen!

Von Januar bis April 2024 haben wir eine Studie durchgeführt, um zu erfahren, wie Schweizer Unternehmen DevOps-Prinzipien umsetzen und anwenden.

Wir haben die Ergebnisse in einer PDF-Datei zusammengefasst (nur in englischer Sprache verfügbar) und wie in der vorherigen Ausgabe geben wir auf den ersten Seiten eine kurze Zusammenfassung unserer Ergebnisse.

Du kannst den Bericht hier herunterladen. Viel Spass beim Lesen und wir freuen uns auf dein Feedback!

Markus Speth

Marketing, Communications, People
Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Allgemein Tech

Hol dir den „DevOps in der Schweiz 2023“ Report

12. Mai 2023

Wir freuen uns, die vierte Ausgabe unseres Reports „DevOps in der Schweiz“ vorstellen zu dürfen!

Von Februar bis April 2022 haben wir eine Studie durchgeführt, um zu erfahren, wie Schweizer Unternehmen DevOps-Prinzipien umsetzen und anwenden.

Wir haben die Ergebnisse in einer PDF-Datei zusammengefasst (nur in englischer Sprache verfügbar) und wie in der vorherigen Ausgabe geben wir auf den ersten Seiten eine kurze Zusammenfassung unserer Ergebnisse.

Du kannst den Bericht hier herunterladen. Viel Spass beim Lesen und wir freuen uns auf dein Feedback!

Aarno Aukia

Aarno ist Mitgründer der VSHN AG und als CTO für die technische Begeisterung zuständig.

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Allgemein Tech

Hol dir den „DevOps in der Schweiz 2022“ Report

25. Mai 2022

Wir freuen uns, die dritte Ausgabe unseres Reports „DevOps in der Schweiz“ vorstellen zu dürfen!

Von Januar bis März 2022 haben wir eine Studie durchgeführt, um zu erfahren, wie Schweizer Unternehmen DevOps-Prinzipien umsetzen und anwenden.

Wir haben die Ergebnisse in einer PDF-Datei zusammengefasst (nur in englischer Sprache verfügbar) und wie in der vorherigen Ausgabe geben wir auf den ersten Seiten eine kurze Zusammenfassung unserer Ergebnisse.

Sie können den Bericht auf unserer Website herunterladen. Viel Spass beim Lesen und wir freuen uns auf Ihr Feedback!

Aarno Aukia

Aarno ist Mitgründer der VSHN AG und als CTO für die technische Begeisterung zuständig.

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt
Presse Tech

K8up für CNCF Projekt Onboarding akzeptiert

19. Nov. 2021

Update: k8up ist jetzt ganz offiziell ein CNCF Sandbox Projekt!

Wir freuen uns sehr, bekanntgeben zu können, dass K8up, der von VSHN entwickelte Kubernetes-Backup-Operator, in den CNCF Project Onboarding-Prozess aufgenommen wurde!

Wir werden nun mit der CNCF zusammenarbeiten, um den Onboarding-Prozess abzuschliessen und alle erforderlichen Informationen für die Übertragung der Projektverantwortung an die CNCF bereitzustellen.

Während dieser Phase werden wir bei VSHN unsere Arbeit fortsetzen und K8up mit neuen Funktionen und Möglichkeiten verbessern. Das GitHub-Projekt ist die Hauptstütze für diese Arbeit und du bist herzlich eingeladen, dir unseren Getting Started Guide anzusehen und mehr über K8up zu erfahren.

Vielen Dank an die CNCF für ihr Vertrauen in K8up! Wir wissen, dass dieses Projekt eine grossartige Ergänzung zur ständig wachsenden Welt der Cloud Native-Projekte sein wird, und wir freuen uns auf seine Zukunft!

Tobias Brunner

Tobias Brunner arbeitet seit über 20 Jahren in der Informatik und seit bald 15 Jahren im Internet Umfeld. Neue Technologien wollen ausprobiert und darüber berichtet werden.

Kontaktiere uns

Unser Expertenteam steht für dich bereit. Im Notfall auch 24/7.

Kontakt